
Ihre KI-Prüfung hat noch nie einen echten Fehler gesehen
Dr. Aaron Hutzler · 25.08.2026 · 7 Min.
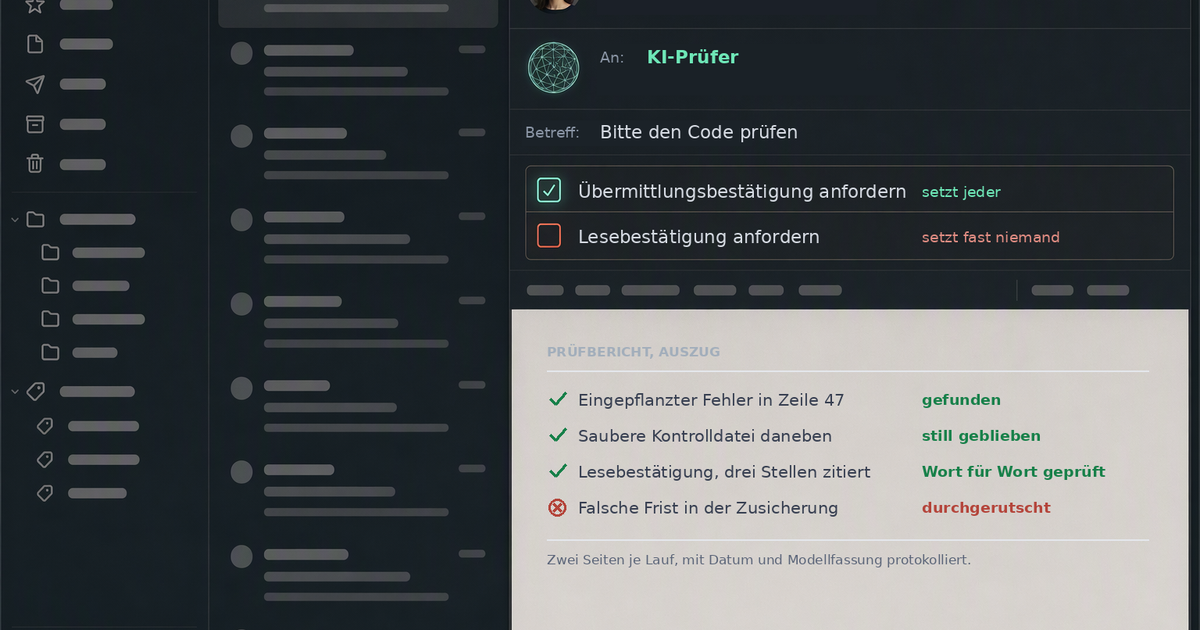
Fast jedes Werkzeug für KI-gestützte Entwicklung lässt die Arbeit der KI von einem zweiten KI-Schritt prüfen. Keines der großen Projekte prüft die eigene Prüfung je an einem echten Fehler. Der Beitrag zeigt die Ursache, dazu den Weg der Fertigung seit Jahrzehnten und drei Schritte, mit denen Sie die Lücke an einem Vormittag schließen.
Sie lassen eine KI arbeiten. Das Modell schreibt Code, fasst ein Dokument zusammen oder entwirft eine Auswertung. Weil niemand einer Maschine blind vertraut, kommt danach eine Prüfung. Oft ist das ein zweiter KI-Schritt: ein Prüf-Agent liest das Ergebnis, füllt einen Bericht aus, vergibt Noten und meldet am Ende .
Diese Prüfung ist inzwischen Standard. Fast jedes Werkzeug für KI-gestützte Entwicklung bringt so etwas mit. Die Berichte sehen gründlich aus. Zehn Kategorien, je eine Note, drei Spalten mit Begründung, eine Schwelle, ab der etwas durchfällt.
In keinem dieser Berichte steht eine Frage. Hätte diese Prüfung einen echten Fehler überhaupt bemerkt?
In der Fertigung ist die Frage eine Selbstverständlichkeit. Bevor ein Messmittel eine Aussage über ein Werkstück treffen darf, wird das Messmittel selbst geprüft. Man legt ihm ein Normal mit bekanntem Maß vor. Zeigt es dieses Maß an? Erst diese Antwort macht aus dem Messmittel eine Messung. Eine Messuhr ohne Prüfung am Normal ist ein Zeiger.
Genau dieser Schritt fehlt bei KI-Prüfungen fast überall. Wir haben die verbreiteten Rahmenwerke für KI-gestützte Entwicklung daraufhin durchgesehen, von den bekanntesten Namen der Szene bis zu kleinen Einzelprojekten, dazu die großen Werkzeugsammlungen für das Prüfen von KI-Antworten [6]. Die Projekte unterscheiden sich in fast allem. Mal prüft ein , mal prüfen fünf. Manche Vorlagen sind streng, andere lassen fast alles zu. Noten vergibt nicht jeder Aufbau.
Keines der großen Projekte gibt seiner eigenen Prüfung je einen bekannten Fehler vor. Überall fehlt dieselbe Messung: Schlägt die Prüfung bei einem echten Fehler an?
Das ist keine Nachlässigkeit einzelner Entwickler, sondern eine Lücke der ganzen Werkzeugschicht. Betroffen ist jeder Anwender solcher Prüfungen. Wer sie kennt, kann sie an einem Vormittag schließen. Wie das geht, steht am Ende dieses Beitrags.
1. Struktur ist nicht Wirksamkeit
Was diese Rahmenwerke bieten, ist erheblich. Rollen mit klaren Übergaben. Pflichtvorlagen für jeden Bericht. Ein Prüfschritt lässt einen Befund erst mit einem echten Auslöser aus dem Produkt gelten. Ein anderer lässt mehrere Prüfer mit je eigener Haltung parallel laufen. Noten verbietet dieser Aufbau ausdrücklich. Ein einzelner Prüfer kann die Tragweite gar nicht beurteilen.
Diese Ideen sind gut und beantworten die Frage nach dem Aufbau. Die Frage nach der Wirkung bleibt offen: Findet dieser Aufbau Fehler, oder füllt er Formulare aus?
In einem der Stacks prüft ein Modell den Code und bewertet anschließend seine eigene Arbeit auf einer Skala von eins bis zehn. Die Skala hat keine Anker. Nirgends steht, was eine Sieben von einer Neun unterscheidet. Die Schwelle liegt bei neun, unter neun fällt der Review durch. Eine Note ohne Anker wandert nach oben. Damit wird die Schwelle zur Formsache.
Die Forschung sagt dasselbe aus drei Richtungen. Ein Modell überarbeitet seine eigene Antwort ohne äußere Rückmeldung und wird dabei im Mittel schlechter [1]. Ein Modell als Prüfer kippt sein Urteil beim Platztausch der beiden Kandidaten [2]. Und ein Modell gibt der Meinung seines Gegenübers nach, statt bei der belegten Antwort zu bleiben [3]. Ein selbst benotender Prüfer ist allen drei Effekten gleichzeitig ausgesetzt. Abbildung 1 ordnet die vier möglichen Ausgänge einer Messung.
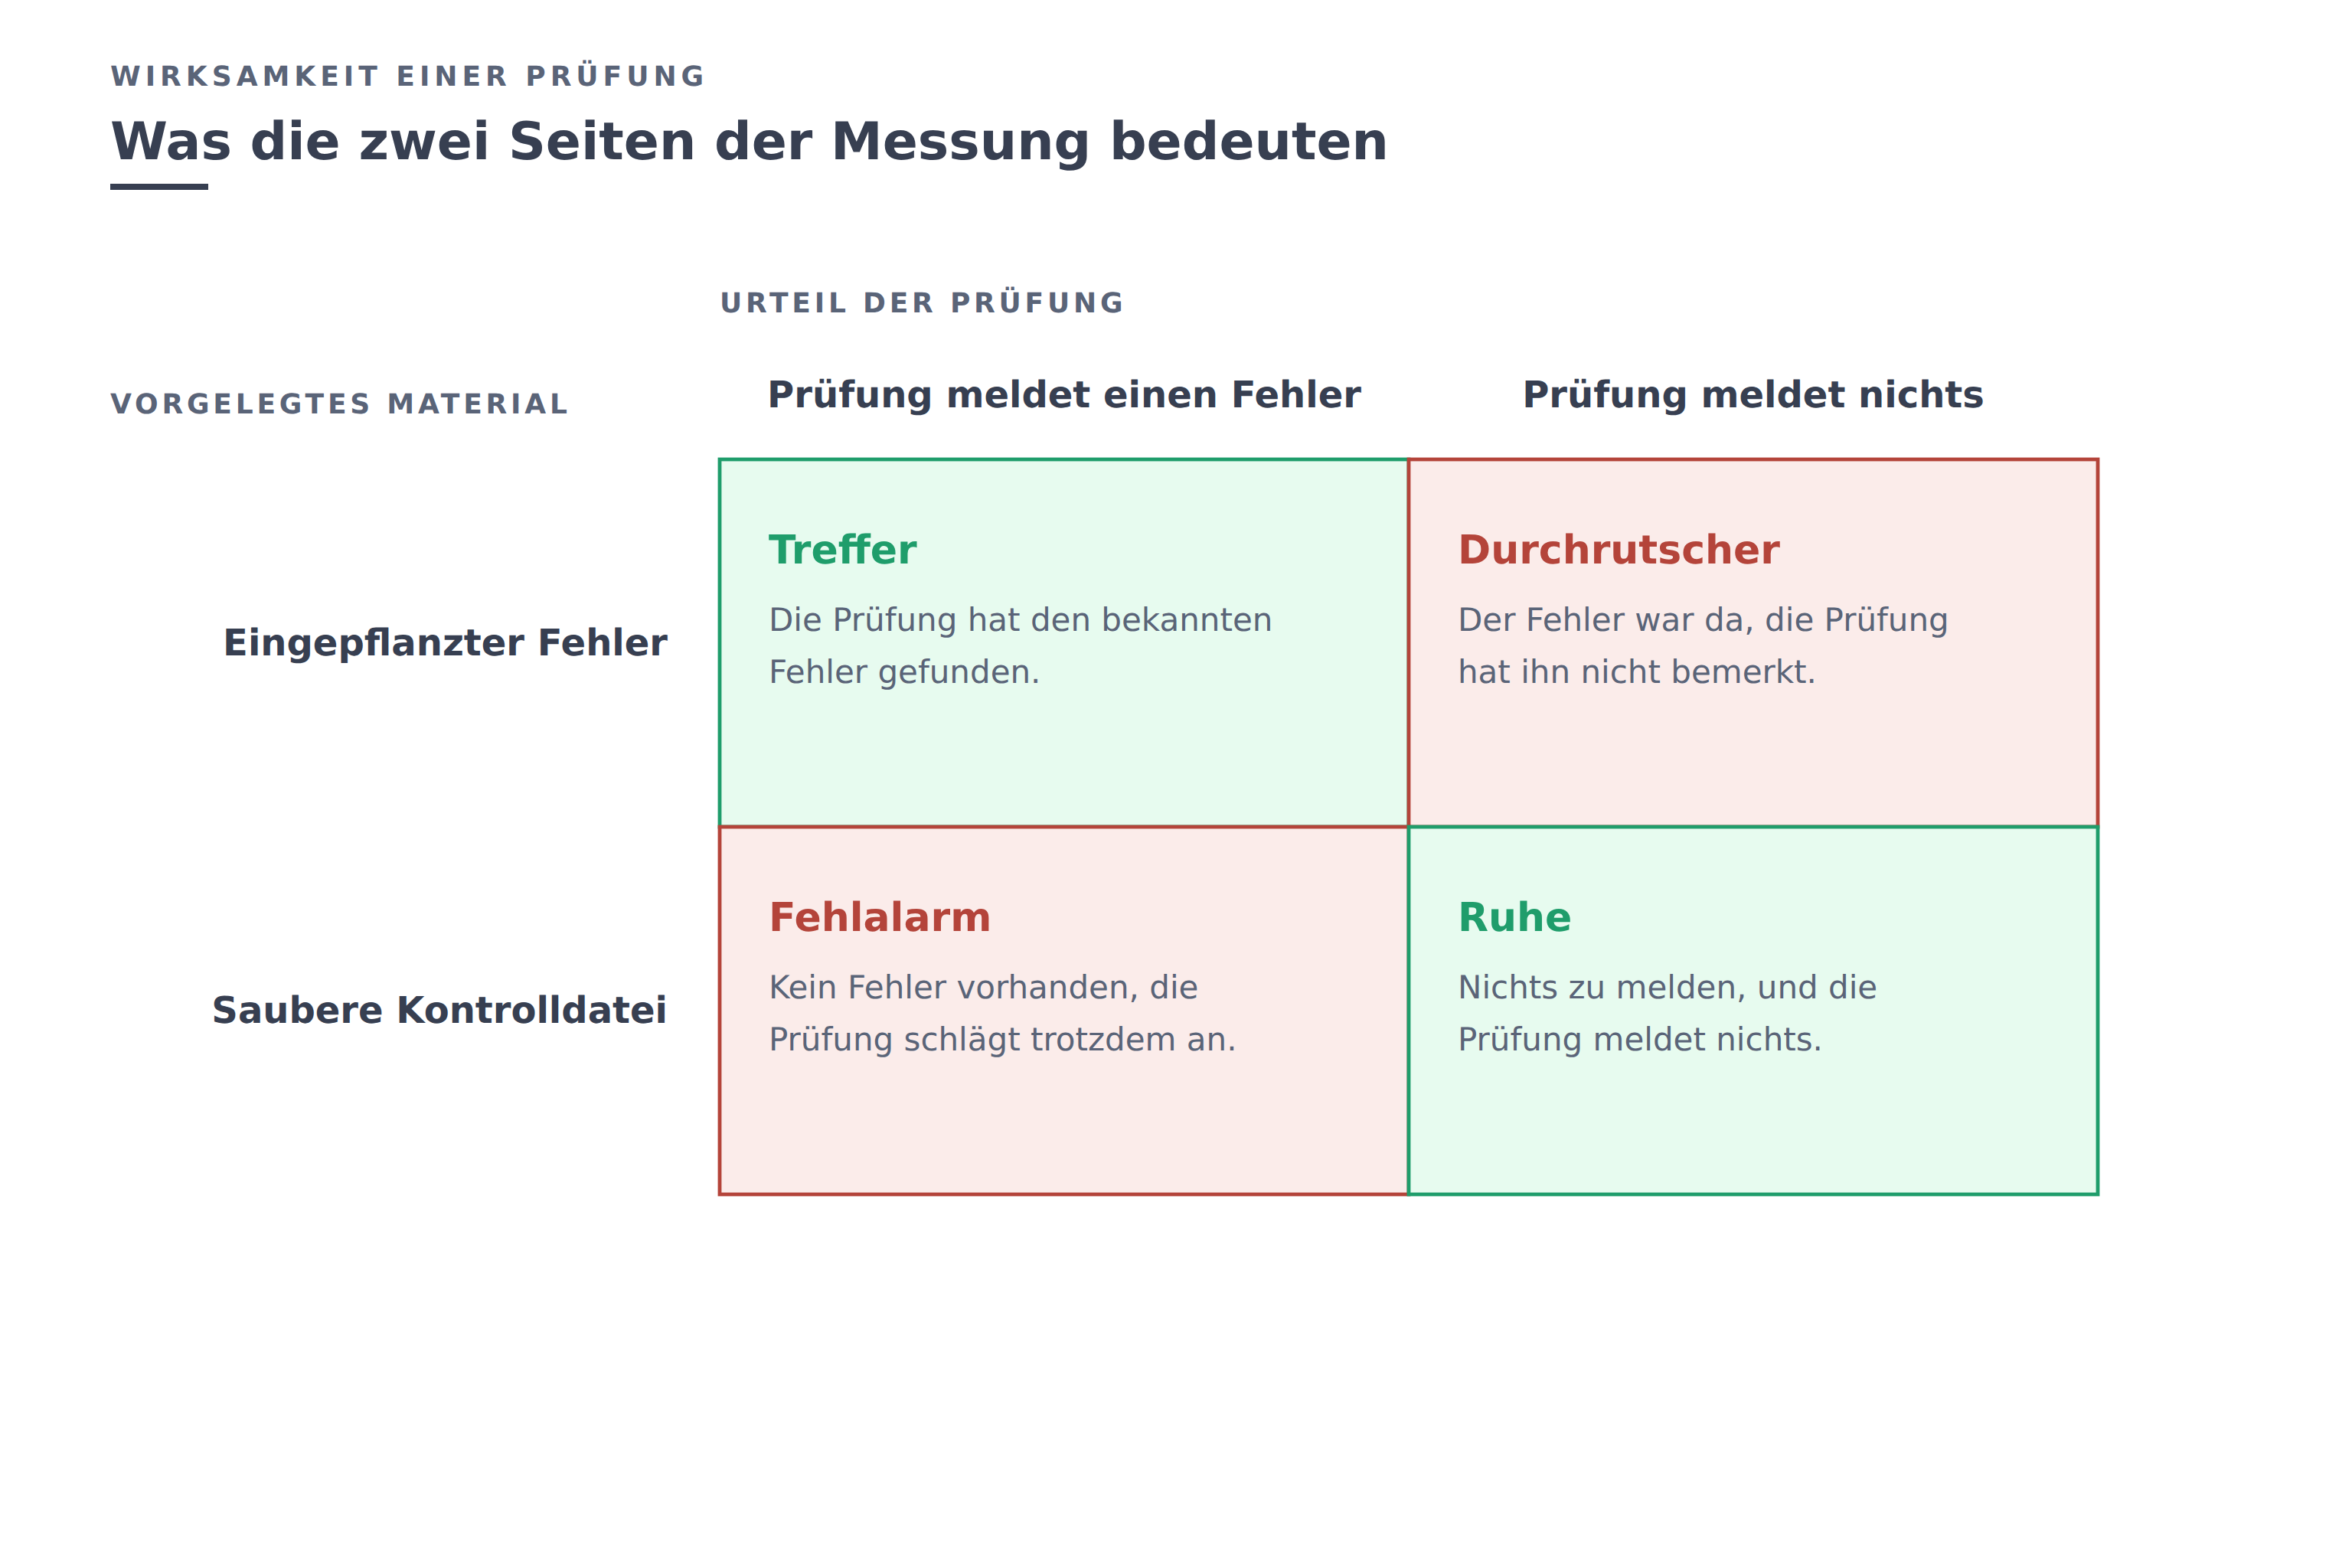
Abbildung 1: Was die zwei Seiten der Messung bedeuten.
Eine Prüfung, die nie gegen einen bekannten Fehler gelaufen ist, ist keine Prüfung. Sie ist eine Gewohnheit.
2. Die Messung braucht zwei Seiten
Der Ausweg ist alt und stammt aus der Fertigung. Man gibt der Prüfung einen bekannten Fehler. Meldet sie ihn?
Das allein reicht nicht. Eine überempfindliche Prüfung findet jeden eingebauten Fehler und ist trotzdem wertlos. Deshalb braucht die Messung zwei Seiten. Die eine: Der eingepflanzte Fehler muss gefunden werden. Die andere: Die saubere Kontrolldatei daneben muss still bleiben. Erst beide Zahlen zusammen sagen etwas aus.
Tabelle 1: Was ein Prüfbericht zusichert und was eine Wirksamkeitsmessung zusichert.
| Eigenschaft der Prüfung | Bericht mit Noten | Messung mit Fehlereinspeisung |
|---|---|---|
| Zeigt, dass geprüft wurde | belegt | belegt |
| Zeigt, wie gründlich geprüft wurde | erfunden | belegt |
| Zeigt, ob ein echter Fehler auffällt | erfunden | belegt |
| Zeigt, ob die Prüfung übertreibt | erfunden | belegt |
| Bleibt über mehrere Läufe vergleichbar | erfunden | belegt |
In unseren eigenen Läufen haben wir bekannte Falschantworten eingespeist und nachgesehen, ob die Prüfung sie meldet [7]. Das ist ein Pilot auf einer einzigen . Über andere Systeme sagt er nichts. Über unsere eigene Prüfung sagt er das, was vorher niemand wusste: Sie schlägt an. Genau darum geht es. Wer seine Prüfung nicht misst, weiß über sie gar nichts.
Der Einwand dagegen gehört genannt. Jemand wird sagen, ein gutes Modell finde einen eingepflanzten Fehler von allein. Vielleicht. Dieselbe Forschung zeigt aber, warum Modelle lieber behaupten als schweigen: Wer rät, wird belohnt. Wer Unsicherheit zugibt, wird bestraft [4]. Und bei langen Programmieraufgaben wächst der Abstand zwischen sichtbaren und zurückgehaltenen Tests mit dem Umfang der Änderung [5]. Beides sind Gründe zu messen statt anzunehmen.
3. Der zweite blinde Fleck: hat der Prüfer gelesen?
In jedem Mailprogramm stehen zwei Kästchen untereinander. Oben die Übermittlungsbestätigung, darunter die Lesebestätigung. Bei einer wichtigen Nachricht setzt jeder den oberen . Den unteren setzt fast niemand. Angekommen lässt sich eben leicht bestätigen, gelesen nicht. Das Titelbild zeigt das Paar.
Bei der KI-Prüfung steht dasselbe Paar. Die Datei lag nachweislich im Kontext des Prüfers. Sein Lesen bleibt unbelegt.
Auf einer Konferenz hieß es zur Frage nach dem Lesen: Sie stelle sich nicht. Alles gehe vollständig an das Modell. Der veröffentlichte Code desselben Stacks sagt etwas anderes. Beim Bauen der Anfrage werden Textdateien ausdrücklich übersprungen. Das Protokoll vermerkt wörtlich das Ignorieren von Dateien ohne Medieninhalt. Verweise auf Dokumente reisen als Pfade mit. Der empfangende Prüfer liest also selbst. Dabei sucht er sich aus, was er liest [6].
Daraus werden zwei getrennte Fragen. Kam der Inhalt überhaupt an? Und hat er das Urteil beeinflusst? Die Frage nach der Wirkung bleibt selbst bei vollständigem offen. Ein Modell übersieht Stellen in der Mitte langer Eingaben.
Beantworten lässt sich das nur mit einem Nachweis ohne eigene Auswahl des Prüfers. Das Verfahren heißt Lesebestätigung. Die Prüfumgebung sucht Stellen im Dokument aus. Der Prüfer muss sie wörtlich zitieren. Ein Abgleich vergleicht danach Zeichen für Zeichen. Was nicht erraten werden kann, muss gelesen worden sein.
4. Was am Montagmorgen zu tun ist
Drei Schritte, keiner davon groß. Abbildung 2 zeigt sie mit dem Ergebnis je Schritt.
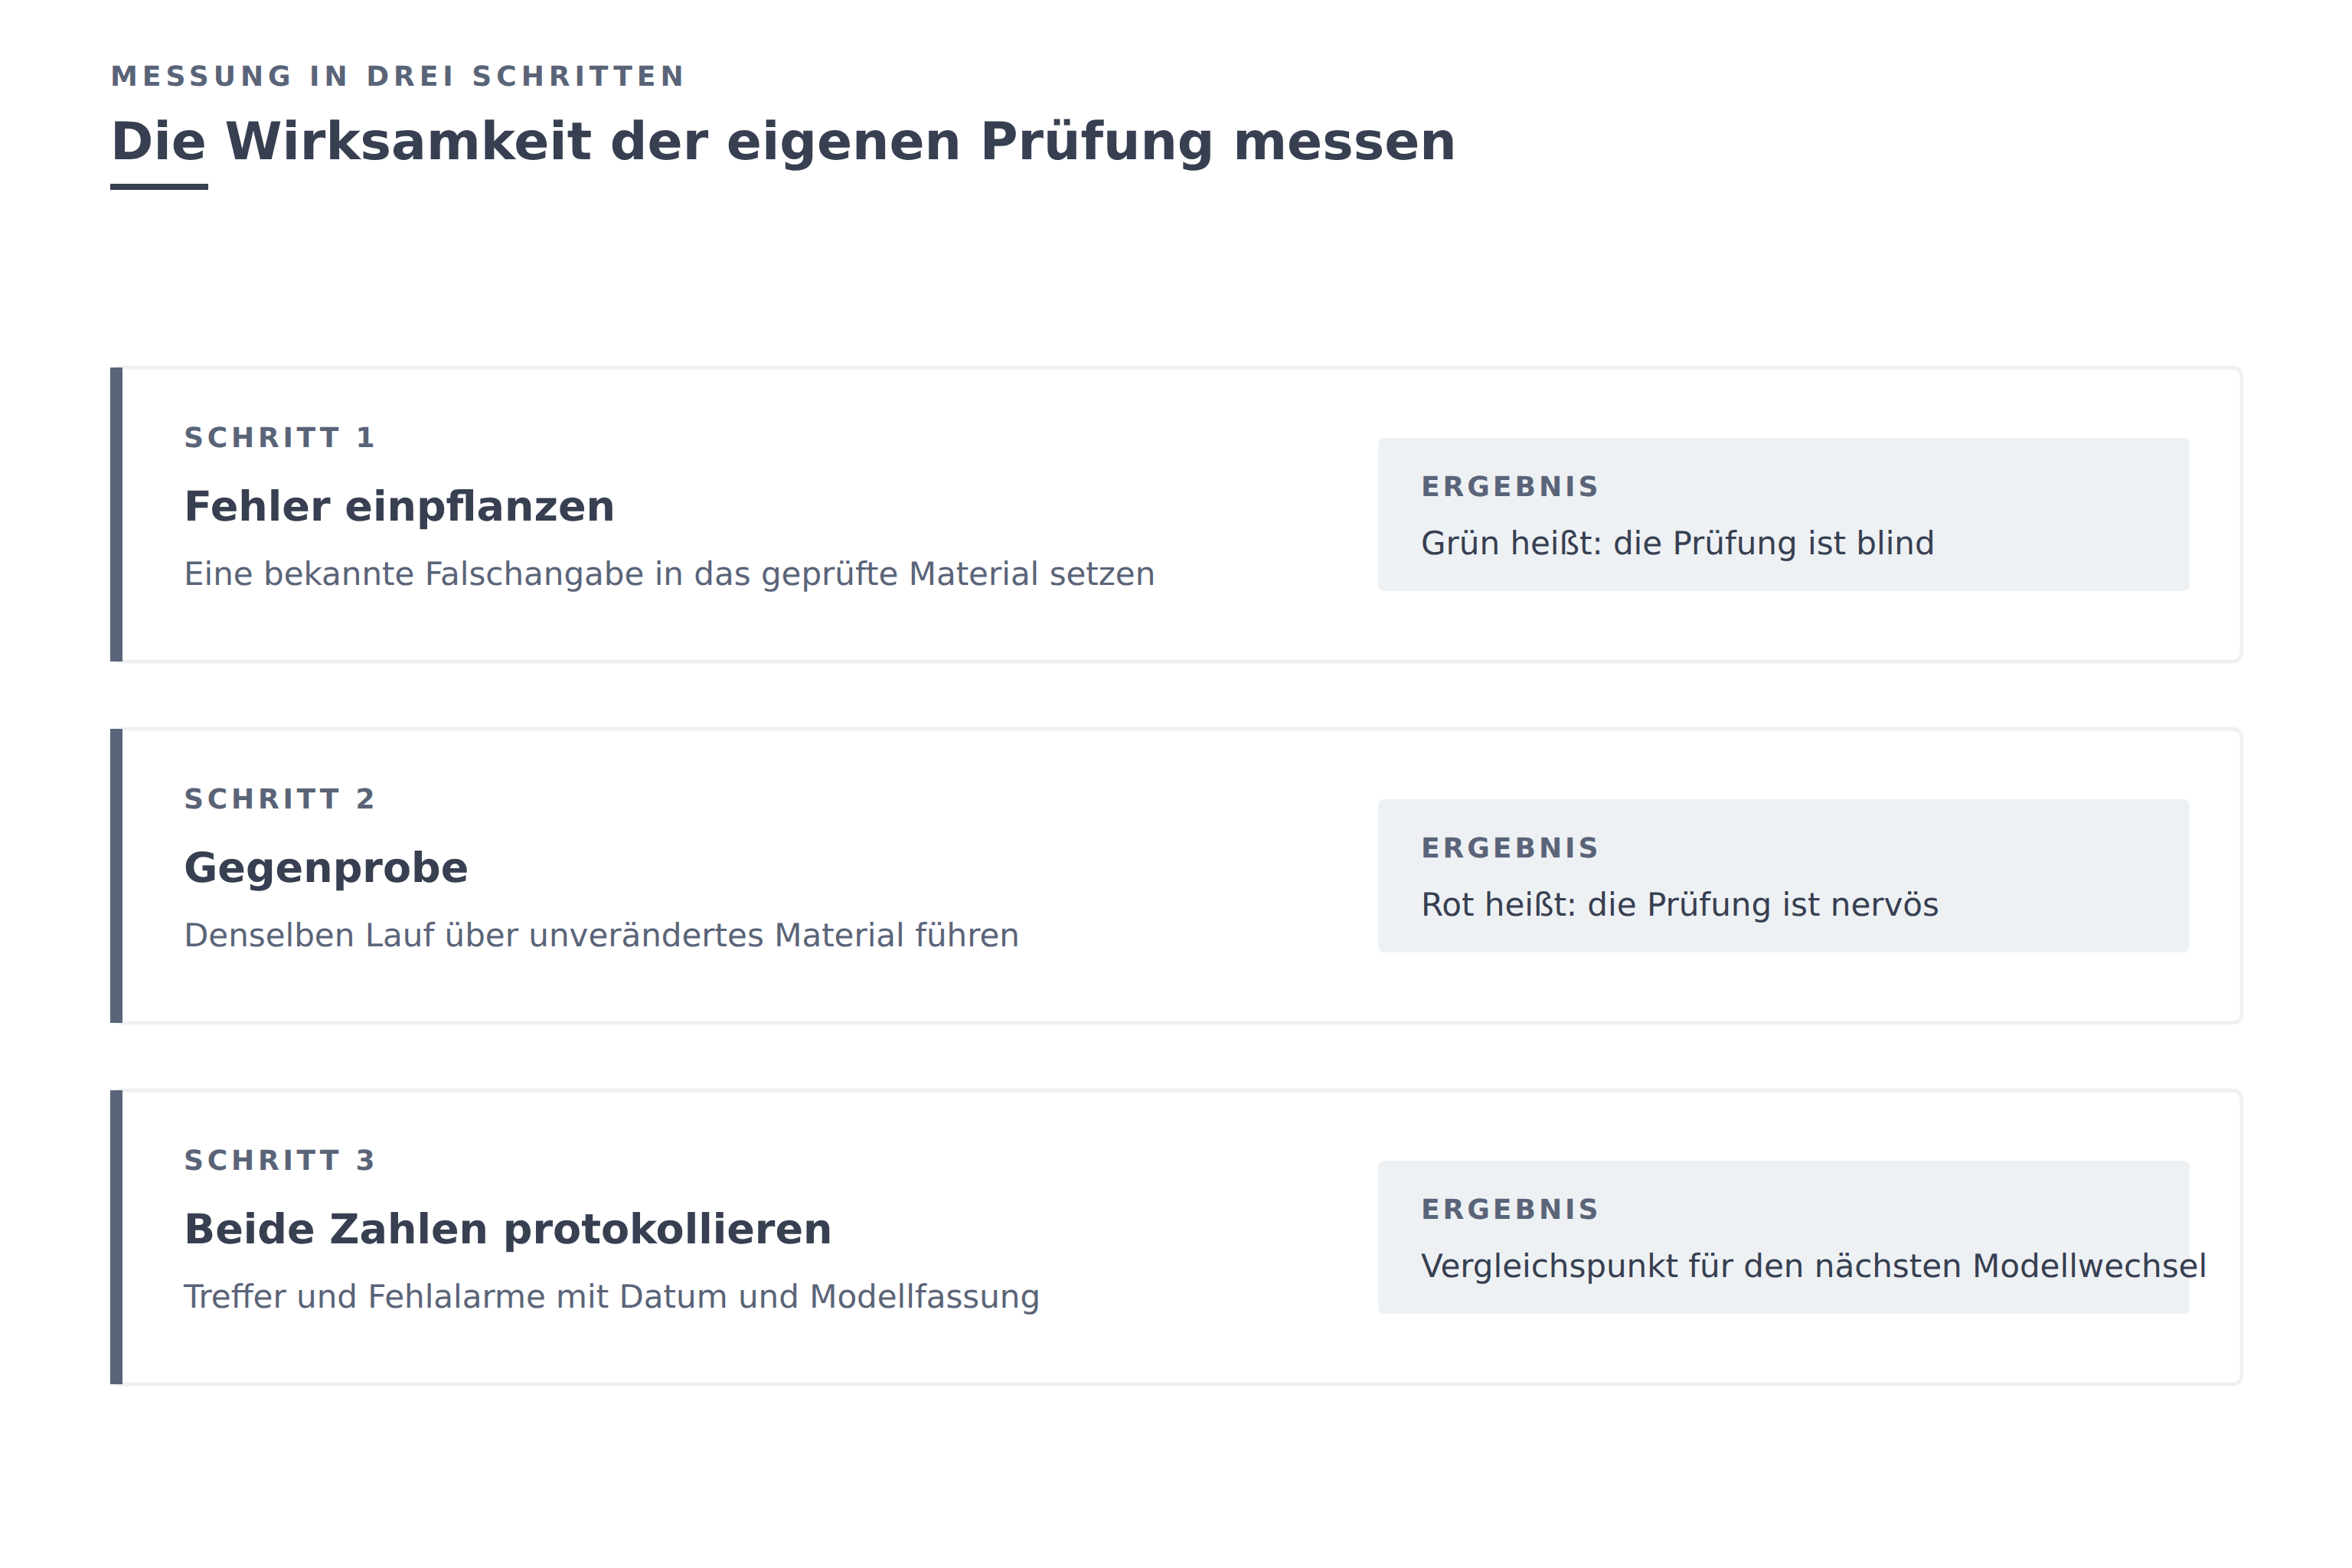
Abbildung 2: Die Messung in drei Schritten.
Erstens, einen Fehler einbauen. Nehmen Sie einen Prüflauf mit regelmäßig grüner Meldung. Bauen Sie in die geprüften Unterlagen einen nachweislich falschen Wert ein: eine Zahl, eine Frist, eine Zusicherung. Starten Sie den Lauf. Meldet er grün, wissen Sie mehr als aus hundert grünen Berichten.
Zweitens, die Gegenprobe. Lassen Sie denselben Lauf über eine unveränderte Unterlage laufen. Schlägt er auch dort an, ist er nicht empfindlich, sondern nervös.
Drittens, beide Zahlen aufschreiben. Gefundene eingepflanzte Fehler und Fehlalarme auf sauberem Material, mit Datum und Modellfassung. Beim nächsten Modellwechsel haben Sie einen Vergleichspunkt. Ohne ihn fällt eine Verschlechterung erst durch einen Hinweis von außen auf.
Der Rest folgt daraus von selbst. Wer die Wirkung seiner Prüfung gemessen hat, kann an ihr arbeiten. Ohne Messung bleibt nur der Glaube daran.
5. Quellen
[1] J. Huang u. a., "Large Language Models Cannot Self-Correct Reasoning Yet", ICLR 2024, arXiv:2310.01798.
[2] P. Wang u. a., "Large Language Models are not Fair Evaluators", arXiv:2305.17926, 2023. https://arxiv.org/abs/2305.17926
[3] M. Sharma u. a., "Towards Understanding in Language Models", arXiv:2310.13548, 2023. https://arxiv.org/abs/2310.13548
[4] A. T. Kalai, O. Nachum, S. S. Vempala und E. Zhang, "Why Language Models Hallucinate", arXiv:2509.04664, 2025.
[5] B. Zhao, D. Srikanth, Y. Wu und Z. Jiang, "SpecBench: Measuring Reward Hacking in Long-Horizon Coding Agents", arXiv:2605.21384, 2026.
[6] Betteryields GmbH, "Eigene Sichtung der verbreiteten Rahmenwerke für KI-gestützte Entwicklung und der großen Werkzeugsammlungen für das Prüfen von KI-Antworten", interne Studie, 2026. Sterne, Abspaltungen, einbindende Projekte und der Archiv-Merker von den Projektseiten gelesen; der veröffentlichte eines Stacks direkt gelesen. Herstellernamen zurückgehalten.
[7] Betteryields GmbH, "Fehlereinspeisung mit bekannten Falschantworten, Fund bei unabhängiger Nachprüfung", eigene Läufe, 2026. Pilotmaßstab, eine Codebasis, nicht auf andere Systeme übertragbar.