
Skills, Prompts, Hacks: ohne automatische Prüfung nützt das alles nichts
Dr. Aaron Hutzler · 18.08.2026 · 4 Min.
Elf KI-Tipp-Grafiken kamen in einer einzigen Woche durch meinen Feed: Prompt-Formeln mit vier Bausteinen, Skill-Sammlungen und ein Rad mit 50 Hacks. Ich habe sie nebeneinandergelegt und gezählt, was sie lehren. Dann kam ein zweiter Stapel. Der Bestand wuchs auf 39 Grafiken ohne Doppel.
1. Was die Spickzettel optimieren
Fast alle beantworten dieselbe Frage: Wie bekomme ich einen besseren ersten Entwurf? Eine Rolle zuweisen. Kontext und Randbedingungen mitgeben. Die Anweisungen zur Wiederverwendung speichern. Das passende Modell wählen. Dieser Rat ist brauchbar und hebt den Durchschnitt.
Ein Ingenieur stellt vor der Auslieferung eine zweite Frage: Wie verhindere ich einen schlechten Entwurf beim Kunden? Also habe ich auch die Antworten darauf gezählt. Die Regel für die Zählung: Eine Stelle zählt nur bei einer maschinell ausgeführten Prüfung. Das heißt ein Test, ein oder ein Punktwert mit Bestehensschwelle. Das nochmalige Durchlesen von Hand zählt nicht: Dabei fällt kein Programm ein Urteil.
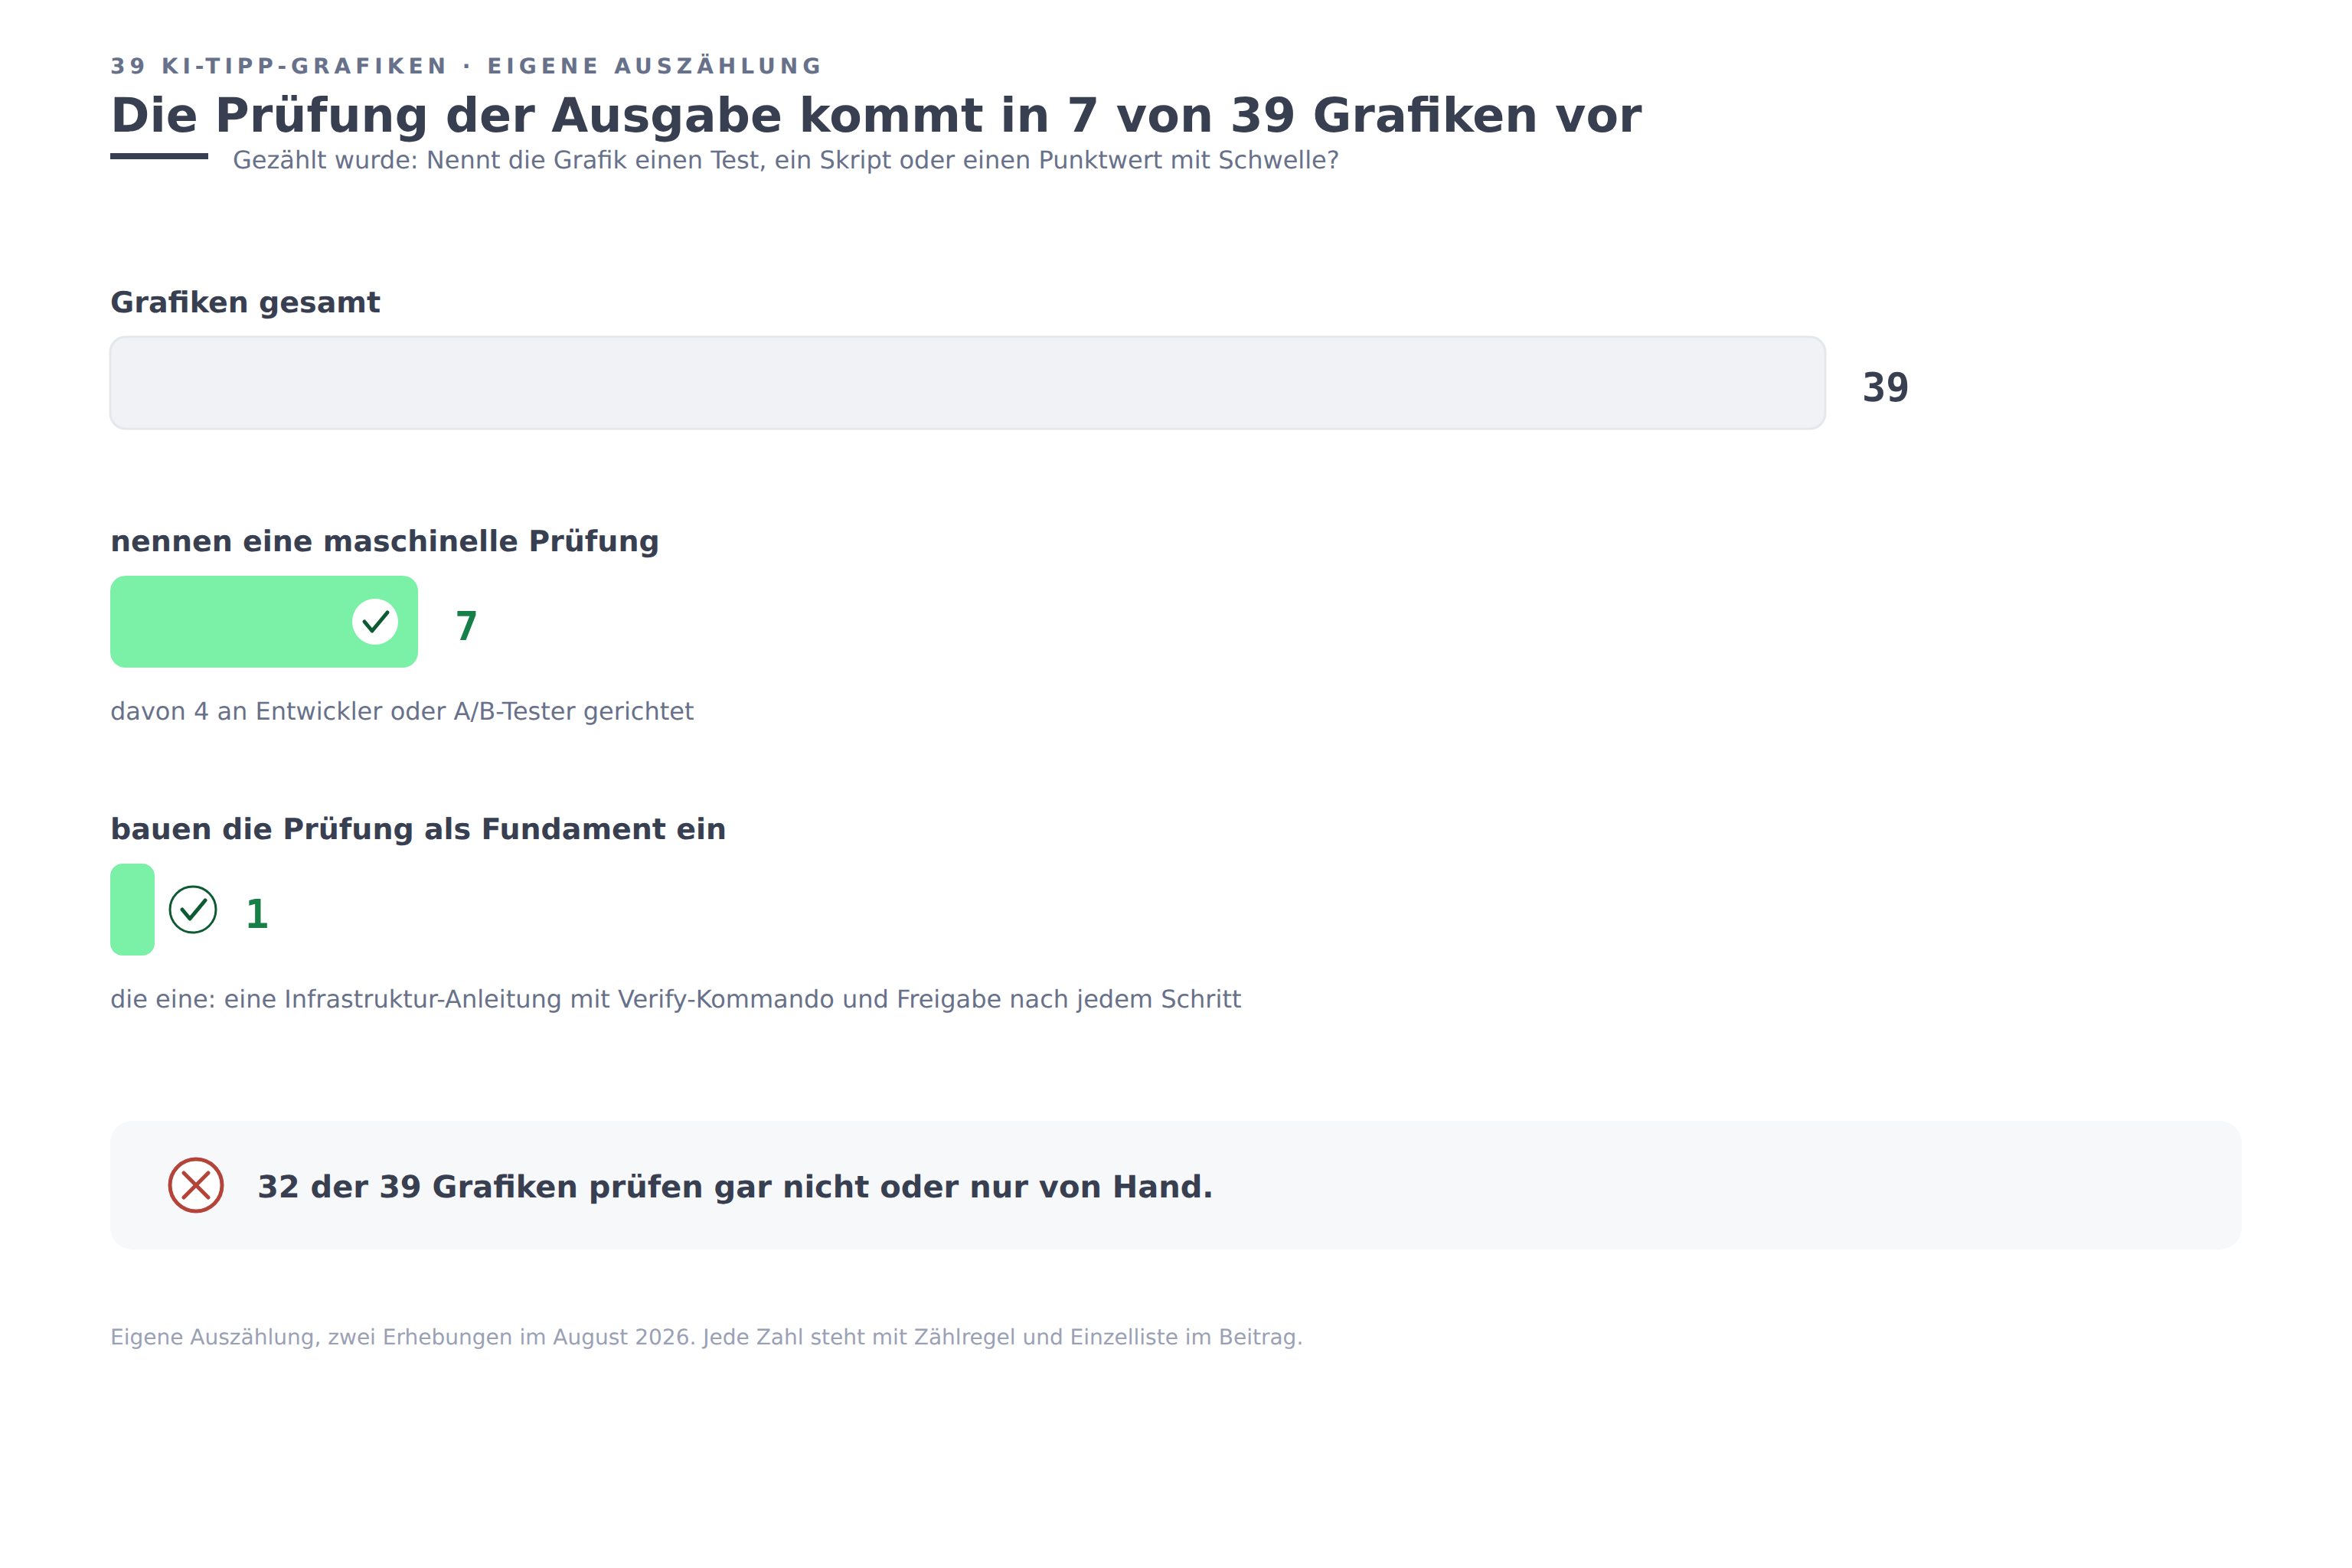
Abbildung 1: Die Zählung über alle 39 Grafiken. Vier der sieben Treffer kommen aus dem Coding-Umfeld oder vom A/B-Testen.
Das Ergebnis, in Abbildung 1 aufgetragen: 7 der 39 Grafiken erwähnen überhaupt eine maschinelle Prüfung. Vier dieser sieben Grafiken richten sich an Software-Ingenieure oder an A/B-Tests. Die meisten Erwähnungen sind ein bis zwei Zeilen und stehen gleichrangig neben Tipps wie der Wahl eines Ausgabestils. Genau eine Grafik behandelt die Prüfung als Fundament: eine Infrastruktur-Anleitung mit einem Verify-Kommando und einer menschlichen Freigabe nach jedem Schritt. Eine von 39 Grafiken.
2. Warum das Verhältnis falsch herum ist
Ein besserer hebt den durchschnittlichen Entwurf. Die teuren Fehler wohnen aber nicht im Durchschnitt. Sie wohnen in den Ausreißern: in der erfundenen Zahl und in der verletzten Hausregel auf Seite 3. Ein Durchschnitt fängt keinen Ausreißer. Eine Prüfung schon: Sie sieht jeden einzelnen Fall an statt nur den Durchschnittsfall. Abbildung 2 zeigt genau diesen Griff.
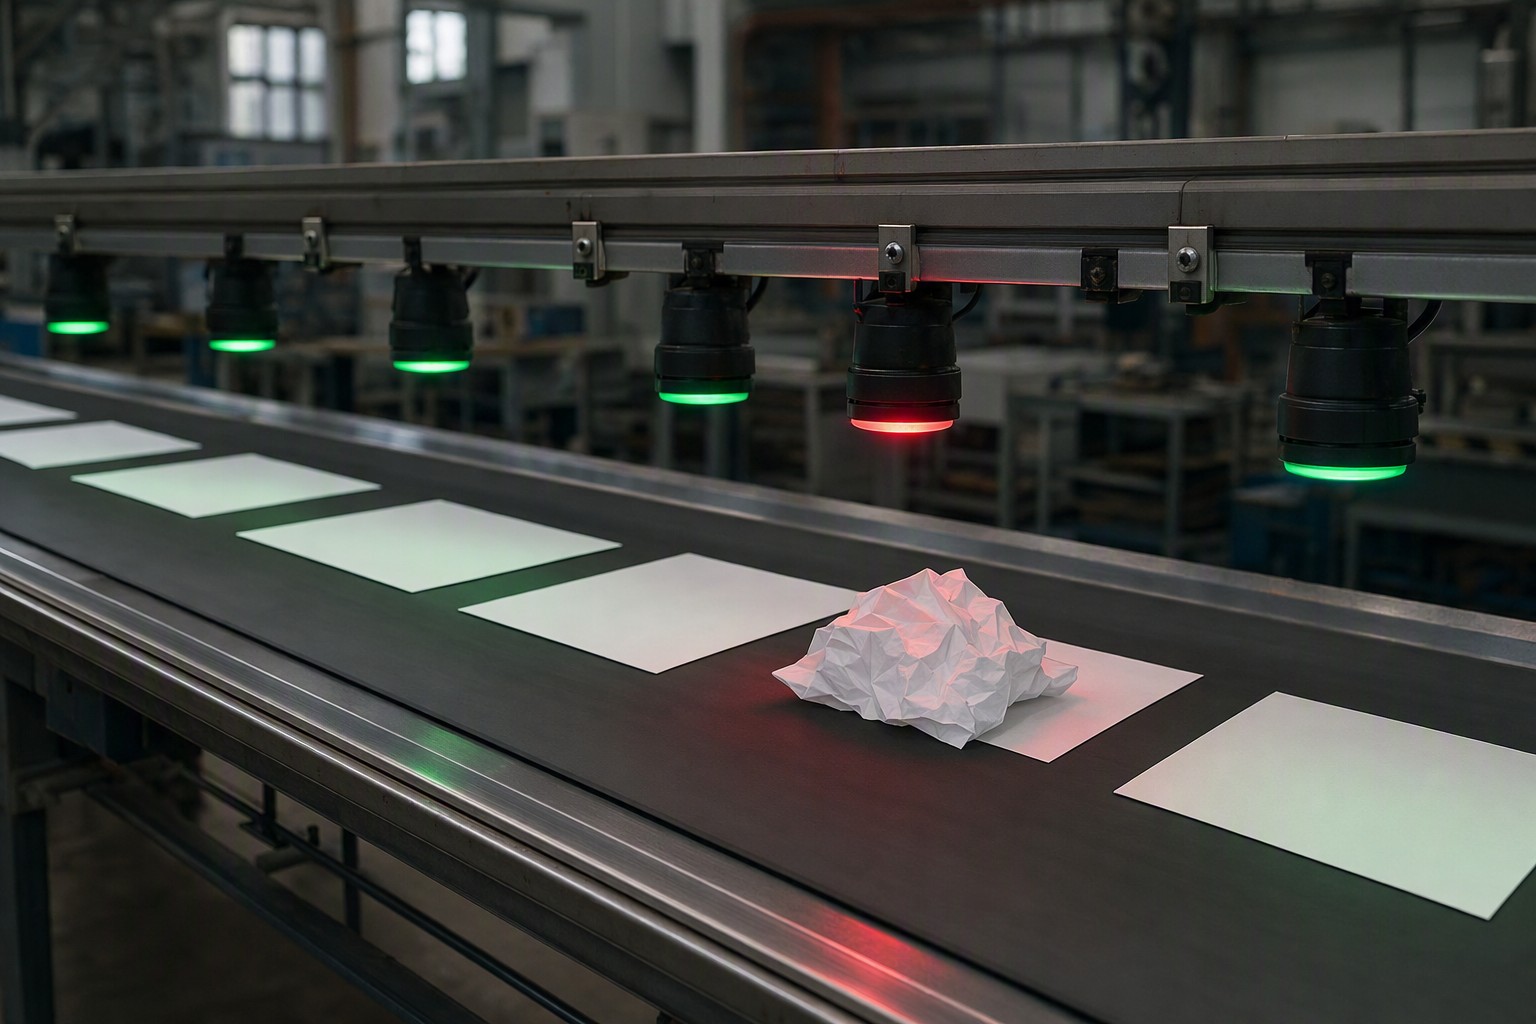
Abbildung 2: Ein zerknittertes Blatt in einer Reihe sauberer. Genau dort springt die Lampe auf .
Bild maschinell erzeugt
Zwei veröffentlichte Messungen zeigen, warum die Eingabeseite die Garantie allein nicht tragen kann. Eine Studie veränderte nur Oberflächenmerkmale eines Prompts ohne Einfluss auf die Aufgabe selbst. Gemessen wurde die Trefferquote derselben Modelle auf denselben Aufgaben: Die Ergebnisse bewegten sich um bis zu 76 Prozentpunkte [1]. Eine zweite Studie prüfte denselben KI-Dienst zweimal im Abstand von drei Monaten auf identischen Aufgaben. Bei einer der geprüften Aufgaben jener Studie fiel die Trefferquote von 84 % auf 51 %. Niemand hatte den Prompt angefasst [2]. Ein derart instabiler Kanal kann Ihren Entwurf verbessern. Zertifizieren kann er ihn nicht.
3. Was eine Prüfung ist
Eine Prüfung ist ein Programm mit einem von zwei Urteilen am Ende. Es liest die Ausgabe und testet eine festgelegte Regel. Ermessen und Tagesform kommen darin nicht vor. Auch der vierzigste Entwurf bekommt keinen Vertrauensvorschuss.
Unser eigenes Marketing-Repository arbeitet so. Dieser Artikel ist durch genau diese Maschinerie gelaufen. Jeder Text hat eine maschinenlesbare Spezifikation mit seiner einen Kernbehauptung. Jede Zahl im Text ist an ein wörtliches Zitat aus ihrer Quelle gebunden. Am Tag der Zählung führte das Prüfregister dieses 38 Prüfungen, davon 31 blockierend. Ein Text erreicht den Inhaber zur Freigabe erst bei komplett grüner Kette. Meine eigene Meinung über einen Text wiegt dabei exakt nichts.
4. Die Frage zum Mitnehmen
Wenn die nächste Tipp-Grafik vorbeizieht, genügt ein einziger Filter. Steht irgendwo, wer die Ausgabe prüft? Und ist dieser Jemand ein Programm? Wo die Antwort Nein lautet, lehrt die Grafik bessere Entwürfe und keine belastbaren Ergebnisse. Ein Skript prüft jede Zahl gegen ihre Quelle. Übersteht Ihre beste KI-Ausgabe diese Prüfung?
5. Wo es weitergeht
Das Muster hat in der Branche einen Namen: Evaluationen, kurz Evals. Eine Übersichtsarbeit von 2023 kartiert das Forschungsfeld und sortiert die Methoden danach, was sie prüfen und wie [3]. Die grossen Modellanbieter empfehlen die Praxis selbst. Einer veröffentlicht eine Anleitung für den Aufbau empirischer Evaluationen vor dem Produktivgang eines Prompts [4]. Ein anderer pflegt ein Rahmenwerk zum Anlegen und Ausführen genau solcher Tests [5]. Für ein erstes eigenes in der Build-Pipeline führt das quelloffene Werkzeug promptfoo Zusicherungen gegen Modellausgaben in der aus. Es läuft dort wie gegen Code [6].
6. Quellen
[1] M. Sclar, Y. Choi, Y. Tsvetkov und A. Suhr, "Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design", ICLR 2024, arXiv:2310.11324. https://arxiv.org/abs/2310.11324
[2] L. Chen, M. Zaharia und J. Zou, "How Is ChatGPT's Behavior Changing over Time?", arXiv:2307.09009, 2023.
[3] Y. Chang u. a., "A Survey on Evaluation of Large Language Models", ACM Transactions on Intelligent Systems and Technology, arXiv:2307.03109, 2023.
[4] "Create strong empirical evaluations", Hersteller-Dokumentation, 2025. https://docs.anthropic.com/en/docs/test-and-evaluate/develop-tests
[5] "Evals", quelloffenes Evaluations-Rahmenwerk, Hersteller-Repository, 2023. https://github.com/openai/evals
[6] "promptfoo", quelloffenes Werkzeug für LLM-Tests, 2025. https://www.promptfoo.dev/