
Spezifikations-getriebene Entwicklung mit KI: die ehrliche Fassung
Dr. Aaron Hutzler · 16.08.2026 · 19 Min.
Sie würden nie in die Fertigung gehen und dem Maschinenbediener das Teil in drei Sätzen beschreiben. Stattdessen geben Sie eine Zeichnung ab: Maße, Toleranzen, Werkstoff, Oberfläche. Das gelieferte Teil entspricht der Zeichnung.
Bei einer KI, die Code schreibt, machen die meisten Teams das Gegenteil. Sie beschreiben das Teil in drei Sätzen und gehen wieder, dann wundern sie sich, dass etwas völlig anderes herauskommt.
Ein wird nach Gebrauch weggeworfen. Eine Spezifikation nicht. Genau darauf baut die auf: Die Beschreibung des Sollverhaltens überlebt als Datei. Mensch und Maschine arbeiten beide aus ihr.
Die Idee selbst ist alt. Neu ist der Preis fürs Auslassen. Eine ungenaue Anforderung kostete früher ein Gespräch: Wer sie nicht verstand, fragte nach. Eine Maschine fragt meist nicht nach. Sie macht aus derselben ungenauen Anforderung eine überzeugende, falsche Umsetzung. Bemerkt wird das erst im Review.
1. Die drei Dateien einer Spezifikation
Ein Prompt nennt ein Ziel und verschwindet. Eine Spezifikation schreibt drei getrennte Dinge auf. Jedes davon überlebt die Sitzung:
- Die Regeln, die für das ganze Vorhaben gelten. Sprache, Aufbau, Verbote, alles einmal geschrieben und gültig für jede Funktion. Der verbreitetste Werkzeugkasten nennt diese Datei die Verfassung.
- Das Sollverhalten. Aufgeschrieben als prüfbare Abnahmekriterien. Nicht "die Anmeldung soll sicher sein", sondern eine Zeile je Regel: Gibt ein Nutzer dreimal einen falschen Code ein, dann sperrt das System das Konto für fünfzehn Minuten.
- Der Bauplan und die Aufgaben. Der technische Entwurf, danach die zerlegten Aufgaben, jede klein genug, dass eine Maschine sie fertig bekommt und ein Mensch sie prüfen kann.
Der arbeitet aus diesen drei Dateien statt aus einem Gesprächsverlauf.
1.1 Spec Coding und seine Synonyme
Die Arbeitsweise läuft unter mehreren Namen. Spec-driven development ist der verbreitetste Begriff. Spec-driven coding und meinen dasselbe. und AI-native Engineering benennen die Arbeitsweise drumherum, von der die Spezifikation nur ein Teil ist.
1.2 Vibe Coding gegen Spec Coding
Andrej Karpathy hat den Begriff am 2. Februar 2025 geprägt [16]. Er leitete einst die KI-Entwicklung bei einem Autohersteller und gründete mit an einem großen Modelllabor. Seine Lehrbestände zu neuronalen Netzen gehören zu den meistbeachteten der Plattform; der Begriff kommt von jemandem, der sein Handwerk versteht.
Seine ursprüngliche Definition ist strenger als der heutige Sprachgebrauch: Man übernimmt jeden Vorschlag, ohne die Änderungen zu lesen. Taucht ein Fehler auf, kopiert man ihn kommentarlos in den Chat zurück. Karpathy hat diese Definition auf Wochenendprojekte zum Wegwerfen eingegrenzt.
Etwa ein Jahr später hat er seine eigene Aussage revidiert. Am 4. Februar 2026 schrieb er [24]: "Today (1 year later), programming via agents is increasingly becoming a default workflow for professionals, except with more oversight and scrutiny." Auf Deutsch: Das Programmieren über Agenten wird für Berufstätige zunehmend zum Regelfall, nur mit mehr Aufsicht und genauerer Prüfung.
Im selben Beitrag nannte er die Arbeitsweise, die er inzwischen bevorzugt: "personally my current favorite 'agentic engineering': agentic because the new default is that you are not writing the code directly 99% of the time, you are orchestrating agents who do and acting as oversight. engineering to emphasize that there is an art and science and expertise to it." Auf Deutsch: agentisch, weil man den Code die meiste Zeit nicht mehr selbst schreibt, sondern Agenten anleitet und beaufsichtigt. Engineering, weil Kunst, Wissenschaft und Können dahinterstehen.
Seine eigene Mängelliste liest sich wie ein Plädoyer fürs Aufschreiben [25]. Die Modelle handeln nach falschen Annahmen, statt sie offenzulegen. Sie fragen selten nach. Sein Rat an derselben Stelle: Diktieren Sie dem Agenten keine Arbeitsschritte. Geben Sie ihm Erfolgskriterien und lassen Sie ihn zuerst die Tests schreiben.
Über den nötigen Umfang der Vorarbeit gehen die Meinungen auseinander. Peter Steinberger arbeitet täglich so, an einem Bestand von rund 300.000 Zeilen. Sein eigener Bericht über die Methode zeigt in zwei verschiedene Richtungen.
In einem Podcast-Gespräch von 2025 beschrieb er ein schweres Verfahren [27]. Er sprach seine Absicht in ein Modell, dessen genug Text auf einmal fasst, ließ sich daraus ein Entwurfsdokument schreiben und gab es in eine frische Sitzung, um es zerpflücken zu lassen. Die Rückfragen wanderten zurück in die erste Sitzung, vier, fünf, sechs Runden lang, bis sie esoterisch wurden. Erst danach ging das Dokument an das Codewerkzeug, mit zwei Wörtern: build spec.md. Dann lief die Maschine stundenlang.
Im Oktober 2025 hat er dieses schwere Verfahren abgeräumt [26]. Große Spezifikationen im Voraus seien die alte Art, über Softwarebau nachzudenken, so seine eigenen Worte. Den Planungsmodus nennt er einen Behelf für ältere Modelle. Geblieben ist ein Gespräch mit dem Agenten, dazu Dokumente für einzelne Aufgaben.
Anfang 2026 hat er dem Ganzen einen Namen gegeben und die Kurve gezeichnet, die er die agentische Falle nennt [28]. Sie beginnt mit dem kurzen Zuruf. In der Mitte stehen acht Agenten, verkettete Abläufe und eine Sammlung eigener Befehle. Am Ende steht wieder der kurze Satz. Zum Begriff Vibe Coding wird er deutlich: "I actually think vibe coding is a slur." Auf die Nachfrage, ob er Agentic Engineering vorziehe, antwortete er: "Yeah, I always tell people I do agentic engineering, and then maybe after 3:00 AM I switch to vibe coding, and then I have regrets on the next day."
Wer daraus liest, er sei gegen das Aufschreiben, liegt falsch. Er ist gegen Zeremonie. Die schriftliche Vorgabe ist nicht verschwunden. Sie ist umgezogen: weg von der großen Spezifikation im Voraus, hin zu festen Dateien im Projekt, die bei jedem Lauf gelten. Ein Vortrag von 2026 zeigt drei davon [29]. Eine verlangt das Gesprächsprotokoll zu jedem Änderungsantrag, damit die aufgewendete Sorgfalt sichtbar wird. Eine lässt jede Änderung von einem zweiten Werkzeug prüfen, bevor sie eingereicht wird. Eine schickt die Tests auf eine frische Maschine, damit der eigene Rechner nicht mitentscheidet.
Das ist derselbe Gedanke, nur woanders festgemacht: Die Regel wohnt jetzt in der Datei neben dem Code.
Diese Eingrenzung ist die ehrliche Grenze des Vergleichs. Tabelle 1 stellt beide Arbeitsweisen nebeneinander. Sie gilt, sobald das Ergebnis in einen Bestand wandert, den ein Zweiter ändern muss.
Tabelle 1: Zwei Arbeitsweisen an derselben Maschine.
| Merkmal | Vibe Coding | Spezifikations-getrieben |
|---|---|---|
| Arbeitsstück nach der Sitzung | der Code, sonst nichts | Regeln, Verhalten, Plan, Aufgaben, dazu der Code |
| Entscheidungsgrundlage | das Ergebnis auf dem Schirm | das vorher aufgeschriebene Kriterium |
| Zeitpunkt der Prüfung | nachdem der Code besteht | bevor der Code besteht |
| Korrekturkosten | eine weitere Erzeugungsrunde | einen Satz |
| Pflege nach sechs Monaten | der Grund für eine Entscheidung ist mit dem Verlauf weg | der Grund steht in einer Datei neben dem Code |
| Architektur | entsteht je Prompt, Einheitlichkeit durch Zufall | Projektregeln einmal geschrieben, gültig für jede Funktion |
| Automatisierbarkeit | ein Gesprächsverlauf läuft in keiner Baustrecke mit | das Arbeitsstück ist eine Datei, also vergleichbar, prüfbar, versionierbar |
| Gegenstand der Prüfung | wer prüft, liest erzeugten Code | wer prüft, liest zuerst die Kriterien und danach den Code |
| Einarbeitung | der Zweite rekonstruiert die Absicht | der Zweite liest sie nach |
| Einsatzbereich | Wegwerf-Skripte, Versuche, Erkundung | jeder Code, den ein Zweiter pflegen muss |
1.3 Die Beleglage zu beiden Arbeitsweisen
An dieser Stelle fangen die meisten Beiträge an zu erfinden, deshalb ganz offen: Es gibt keine kontrollierte Untersuchung, die beide Arbeitsweisen direkt gegeneinander misst. Eine Vorher-Nachher-Studie versucht es [17]. Sie lief ohne Kontrollgruppe, mit vierzehn Entwicklern in einem Unternehmen. Über die vier Monate der Studie besserten sich die Modelle selbst. Die eigenen Autoren nennen die Zahlen deshalb Richtwerte.
Messwerte gibt es nur für die KI-gestützte Arbeit im Ganzen, ohne Trennung nach Arbeitsweise. Diese Befunde gelten deshalb für beide:
- Befunde bleiben liegen. Von über 300.000 KI-geschriebenen , den einzelnen gespeicherten Änderungen, war gut ein Fünftel der eingebrachten Befunde im neuesten Stand noch vorhanden. Fast alle davon sind Geruchsmuster im Code [18]. Grenze: offener , die Urheberschaft ist aus Signalen der Übernahme erschlossen.
- Geprüft wird oft gar nicht. Von den KI-erzeugten Änderungsanträgen einer großen Stichprobe trägt die Mehrheit überhaupt keine festgehaltene Prüfung. Wo geprüft wurde, war der Prüfer häufig selbst ein Agent [19]. Grenze: stille Freigaben sind in den Daten unsichtbar.
- Die Sicherheit bleibt stehen. Knapp die Hälfte des erzeugten Codes brachte eine bekannte Schwachstellenklasse mit. Über die Modellgenerationen hinweg besserte sich dieser Anteil nicht [20]. Grenze: ein Anbieter-Prüfsatz mit künstlichen Aufgaben, er misst die Neigung und nicht das Vorkommen im Feld.
- Schneller wird es nicht von selbst. In einem Zufallsversuch mit 16 erfahrenen Entwicklern an Beständen, an denen sie seit Jahren arbeiteten, machte der erlaubte KI-Einsatz sie 19 % langsamer. Sie selbst glaubten, schneller geworden zu sein [21]. Grenze: sechzehn Entwickler, vertraute Bestände, frühe Werkzeuge.
- Die Wartbarkeit leidet aber auch nicht sichtbar. In einem zweistufigen Versuch mit 151 Entwicklern entwickelte eine zweite Gruppe den entstandenen Code ohne KI weiter. Kein bedeutsamer Unterschied in Zeit oder Qualität [22]. Das ist ein Nullbefund, er spricht gegen die Schwarzmalerei.
Und ein Befund spricht direkt gegen die spezifikations-getriebene These. In einem Versuch über 90 Aufgaben und fünf Modelle brachten immer ausführlichere Vorgaben keine statistisch bedeutsame Verbesserung der Architekturqualität. Die stärksten Modelle schrieben die längsten Methoden [23]. Struktur im Eingang ist nicht von selbst Struktur im Ausgang.
Beide Arbeitsweisen überlassen eines einem Dritten: Der Aufruf einer Funktion, die es nie gab, kommt in beiden durch. Erst eine Prüfung außerhalb des Modells fängt ihn ab.
2. Der Grund für eine Spezifikation
Jedes Vorhaben reicht eine Absicht durch mehrere Hände: vom Bedarf zur Produktanforderung, von der Anforderung zum Entwurf, vom Entwurf zur Umsetzung, von der Umsetzung zur Auslieferung. Das Argument in [7] lautet: Ohne ein gemeinsames Arbeitsstück, das die Absicht trägt, wird jede dieser Übergaben zu einem Akt der Auslegung.
Die spezifikations-getriebene Entwicklung stellt ein Arbeitsstück in die Mitte dieser Kette und behält es dort.
2.1 Die Beleglage zum Nutzen einer Spezifikation
Vier Befunde tragen echte Zahlen, jeder mit seiner eigenen Grenze.
Die Form der Vorgabe entscheidet über das Ergebnis. In [1] bekamen fünf Sprachmodelle dieselben Aufgaben zweimal, einmal als knappe Beschreibung und einmal als strukturierte Spezifikation. Mit der knappen Beschreibung bestand kein einziger Test. Mit der strukturierten Spezifikation bestanden 99,1 % der Tests. Verändert wurde nur die Form der Vorgabe. Modell und Aufgabe blieben gleich. Grenze: eine Pilotstudie an drei kleinen Steuerungssystemen.
Der häufigste Fehler war dabei immer derselbe: Das Modell ruft eine Funktion auf, die es in der gar nicht gibt. Knapp die Hälfte aller Fehler war von dieser Art. Der größere Teil aller Fehlschläge wäre schon einem Prüfprogramm aufgefallen, das den Code nur liest und nie ausführt.
Der eigentliche Befund zeigt nicht auf das Modell. Wenn ein Prüfprogramm, das nur liest, den Großteil der Fehler findet, dann war der Ablauf die schwache Stelle. Der Schritt war schlicht nicht eingebaut. Eine Spezifikation behebt das nicht von allein. Sie hält den Prüfschritt nur schriftlich fest, deshalb läuft er jedes Mal.
Reparaturen an der Beschreibung lassen sich automatisieren. In [2] lief ein Programm über die Aufgabenbeschreibungen, bevor das Modell sie zu sehen bekam. Es fand fehlende Angaben bei 43,58 % der Beschreibungen und ergänzte sie. Genau dort löste das Modell danach 30,9 % mehr Aufgaben richtig. Über den ganzen Prüfsatz gerechnet bleiben davon nur 4,09 Prozentpunkte übrig, weil die meisten Beschreibungen von vornherein in Ordnung waren. Grenze: kurze, in sich geschlossene Funktionsaufgaben, keine echten Bestände, kein Mensch dazwischen.
Mehrdeutigkeit verschlechtert jedes Modell. In [3] blieb die Anforderung an einer Stelle absichtlich offen. Jedes geprüfte Modell wurde dadurch schlechter. Aus derselben offenen Anforderung entstanden Umsetzungen, die sich im Verhalten unterschieden. Kein einziges Modell fragte nach. Grenze: Funktionsebene, ein neuer Prüfsatz mit 1.304 Aufgaben, von Dritten nicht wiederholt.
Das Bild der Branche bleibt unbequem. In [9] wurden knapp 5.000 Fachleute befragt. Fast alle nutzen KI bei der Arbeit. Knapp ein Drittel traut dem erzeugten Code wenig oder gar nicht. Wer stark auf KI setzt, liefert häufiger aus. Die ausgelieferte Software hält schlechter. Grenze: Die Befragten haben sich selbst eingeschätzt, ein Zusammenhang ist noch keine Ursache, spezifikations-getriebene Entwicklung kommt in der Befragung gar nicht vor.
Zusammengenommen sagen diese Befunde etwas Engeres als die Werbung. Eine bessere Spezifikation verbessert messbar den erzeugten Code. Ob ein Team deshalb am Ende bessere Software ausliefert, hat bislang niemand gemessen.
3. Der Ablauf in sechs Stufen
Sechs Stufen, zu sehen in Abbildung 1. Die vorbereitenden Stufen laufen, bevor eine Zeile Code besteht.
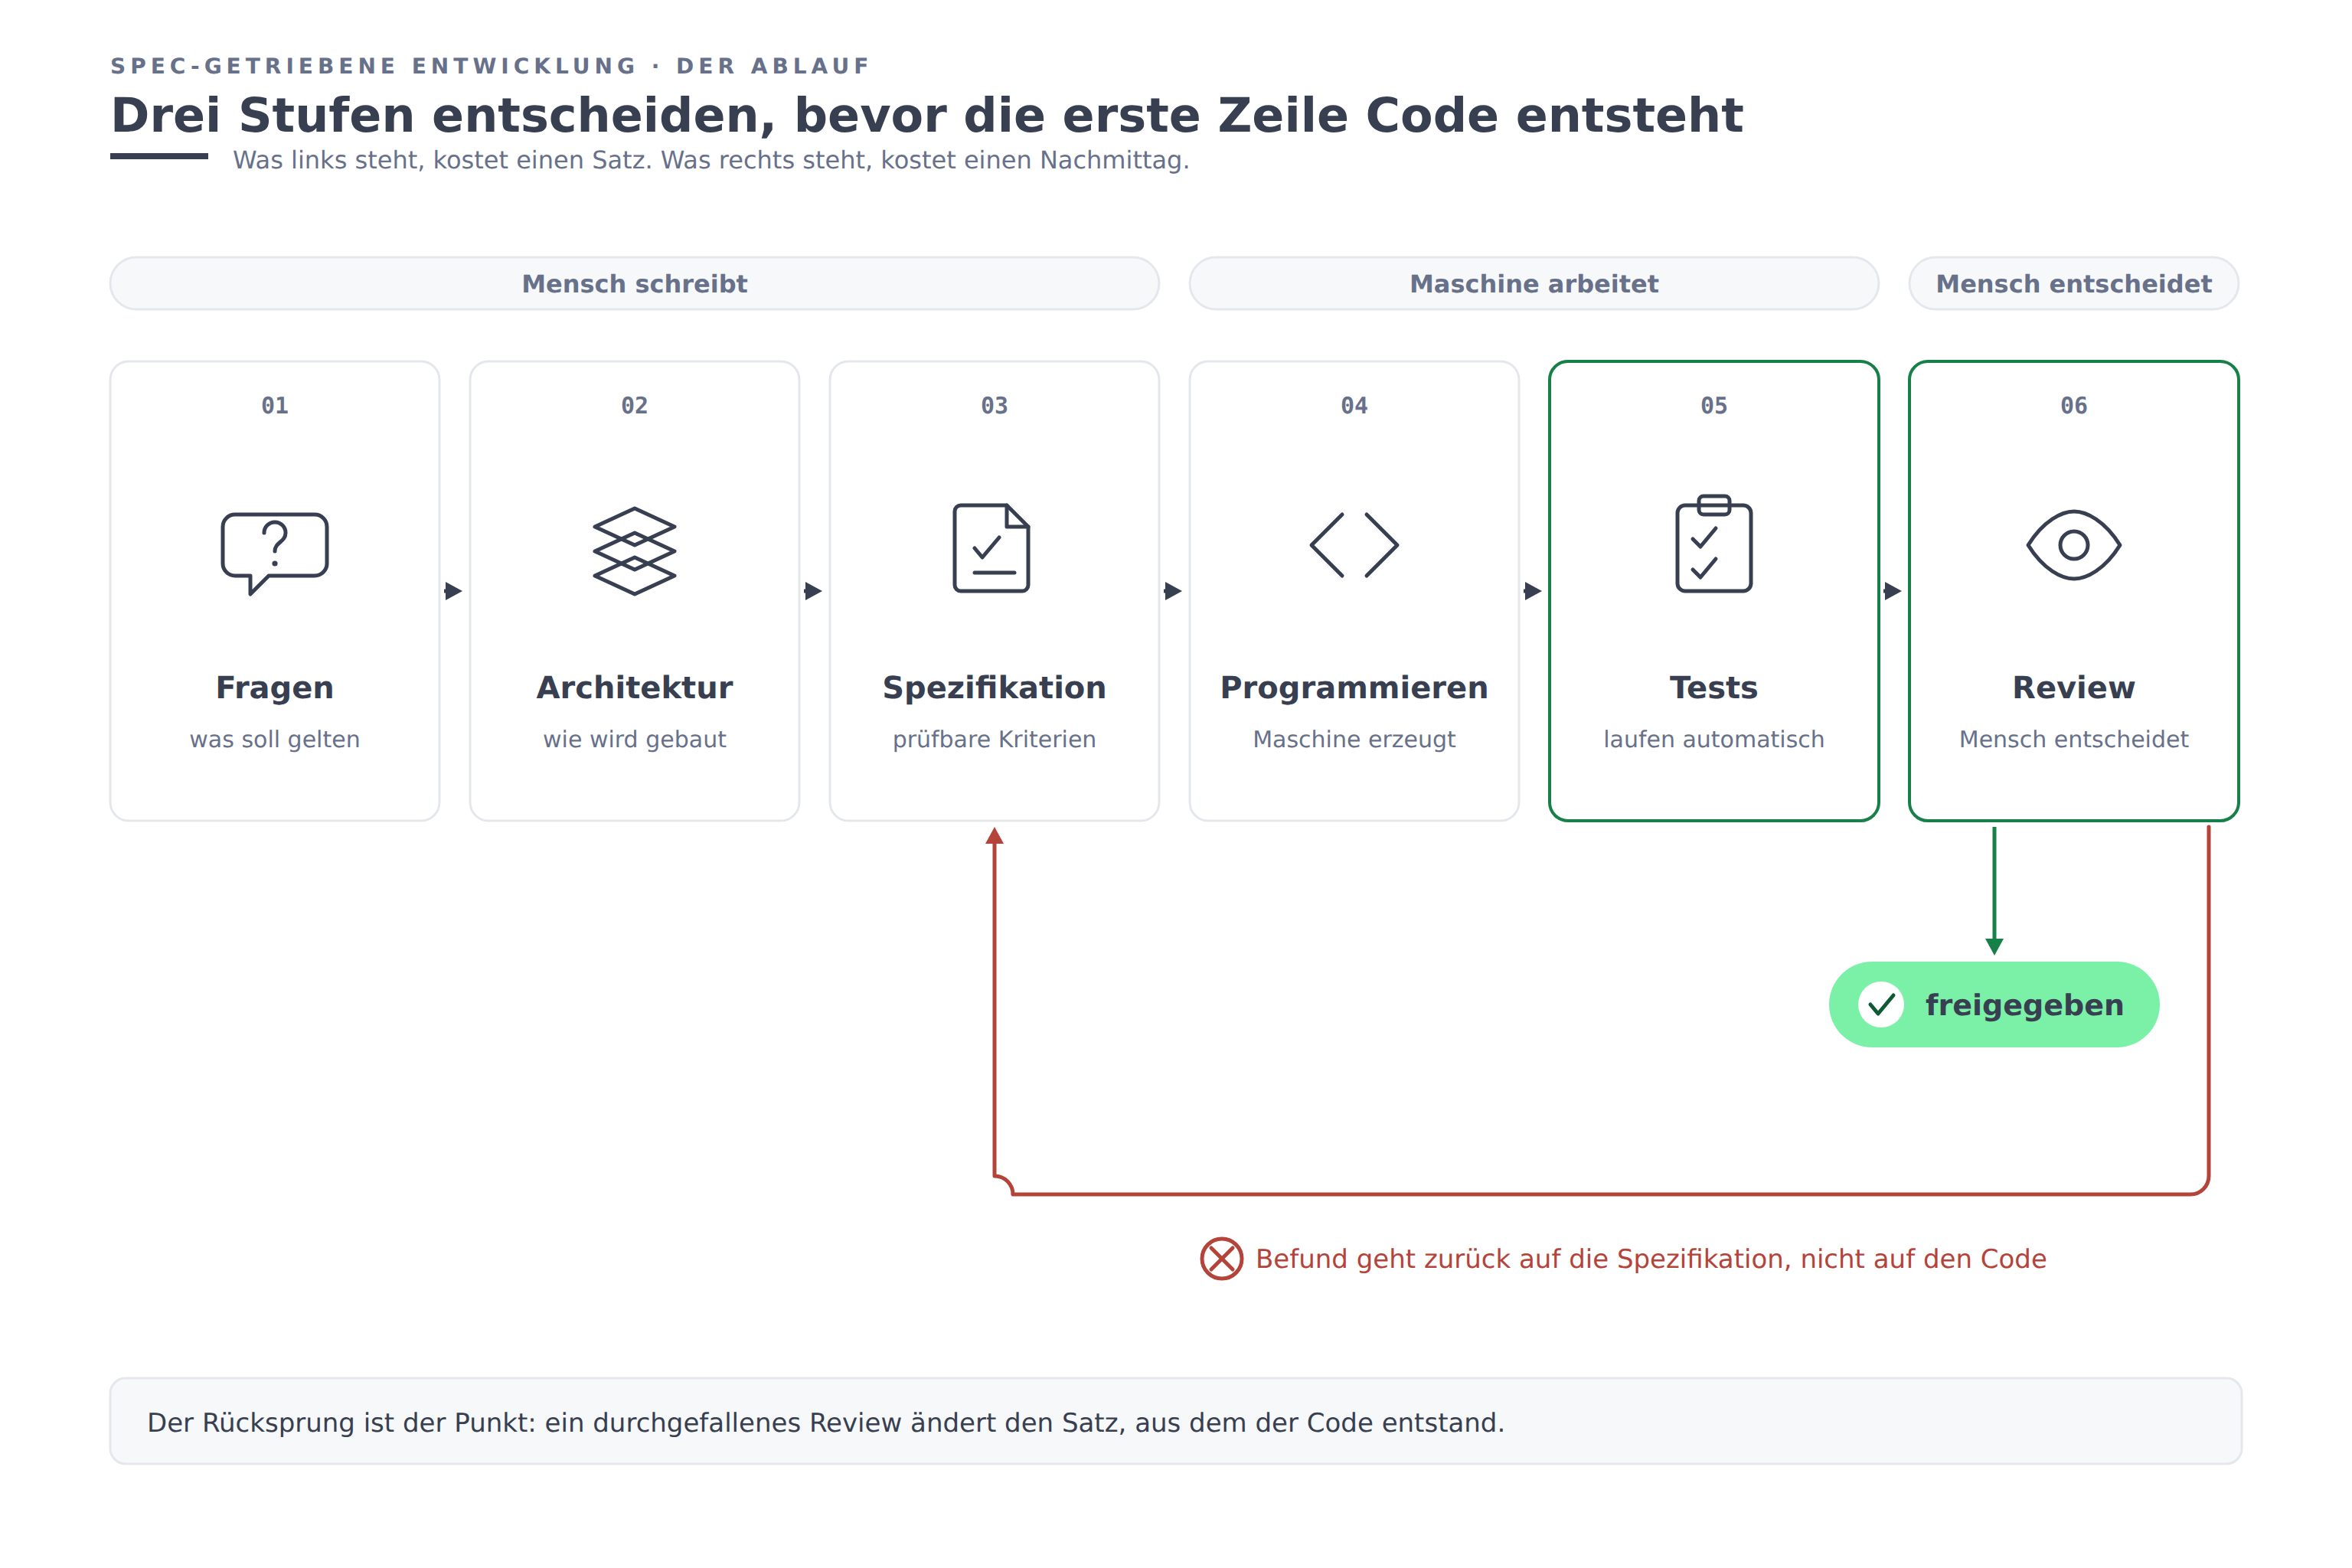
Abbildung 1: Die . Fragen und Architektur legen die Grundregeln und die Bauweise fest. Die Spezifikation macht daraus Kriterien, die ein Test prüfen kann. Erst danach schreibt die Maschine Code. Das Review entscheidet. Ein durchgefallenes Review geht zurück auf die Spezifikation statt auf den Code.
Die billigen Korrekturen stehen links. Ein Satz in der Spezifikation kostet Sekunden. Der erzeugte Bestand dahinter kostet einen Nachmittag.
3.1 Die drei Stufen der Strenge
Die Strenge der Spezifikation ist eine eigene Entscheidung. Tabelle 2 nennt die drei üblichen Stufen.
Tabelle 2: Die drei Stufen der Strenge, nach [4] und [10].
| Stufe | Die Spezifikation | Der Code |
|---|---|---|
| spec-first | vor dem Code geschrieben, danach verworfen | das dauerhafte Arbeitsstück |
| spec-anchored | bleibt und wird neben dem Code gepflegt | das dauerhafte Arbeitsstück |
| spec-as-source | das dauerhafte Arbeitsstück | erzeugt, nicht von Hand bearbeitet |
Die meisten Teams, die darüber berichten, arbeiten auf den ersten beiden Stufen. Die dritte Stufe trägt die offenen Fragen. Genau die benennt [4] deutlich: Ein erzeugtes Arbeitsstück aus einem nicht wiederholbaren Erzeuger erbt die Nachteile beider Welten, Unbeweglichkeit und fehlende Wiederholbarkeit zugleich.
3.2 Die Werkzeuge und ihre Phasen
Vier Werkzeugkästen prägen das Feld. Ihre Phasennamen gehen auseinander. Ihr Aufbau kaum. Abbildung 2 zeigt den Ablauf des bekanntesten davon. Tabelle 3 stellt die Benennungen nebeneinander.
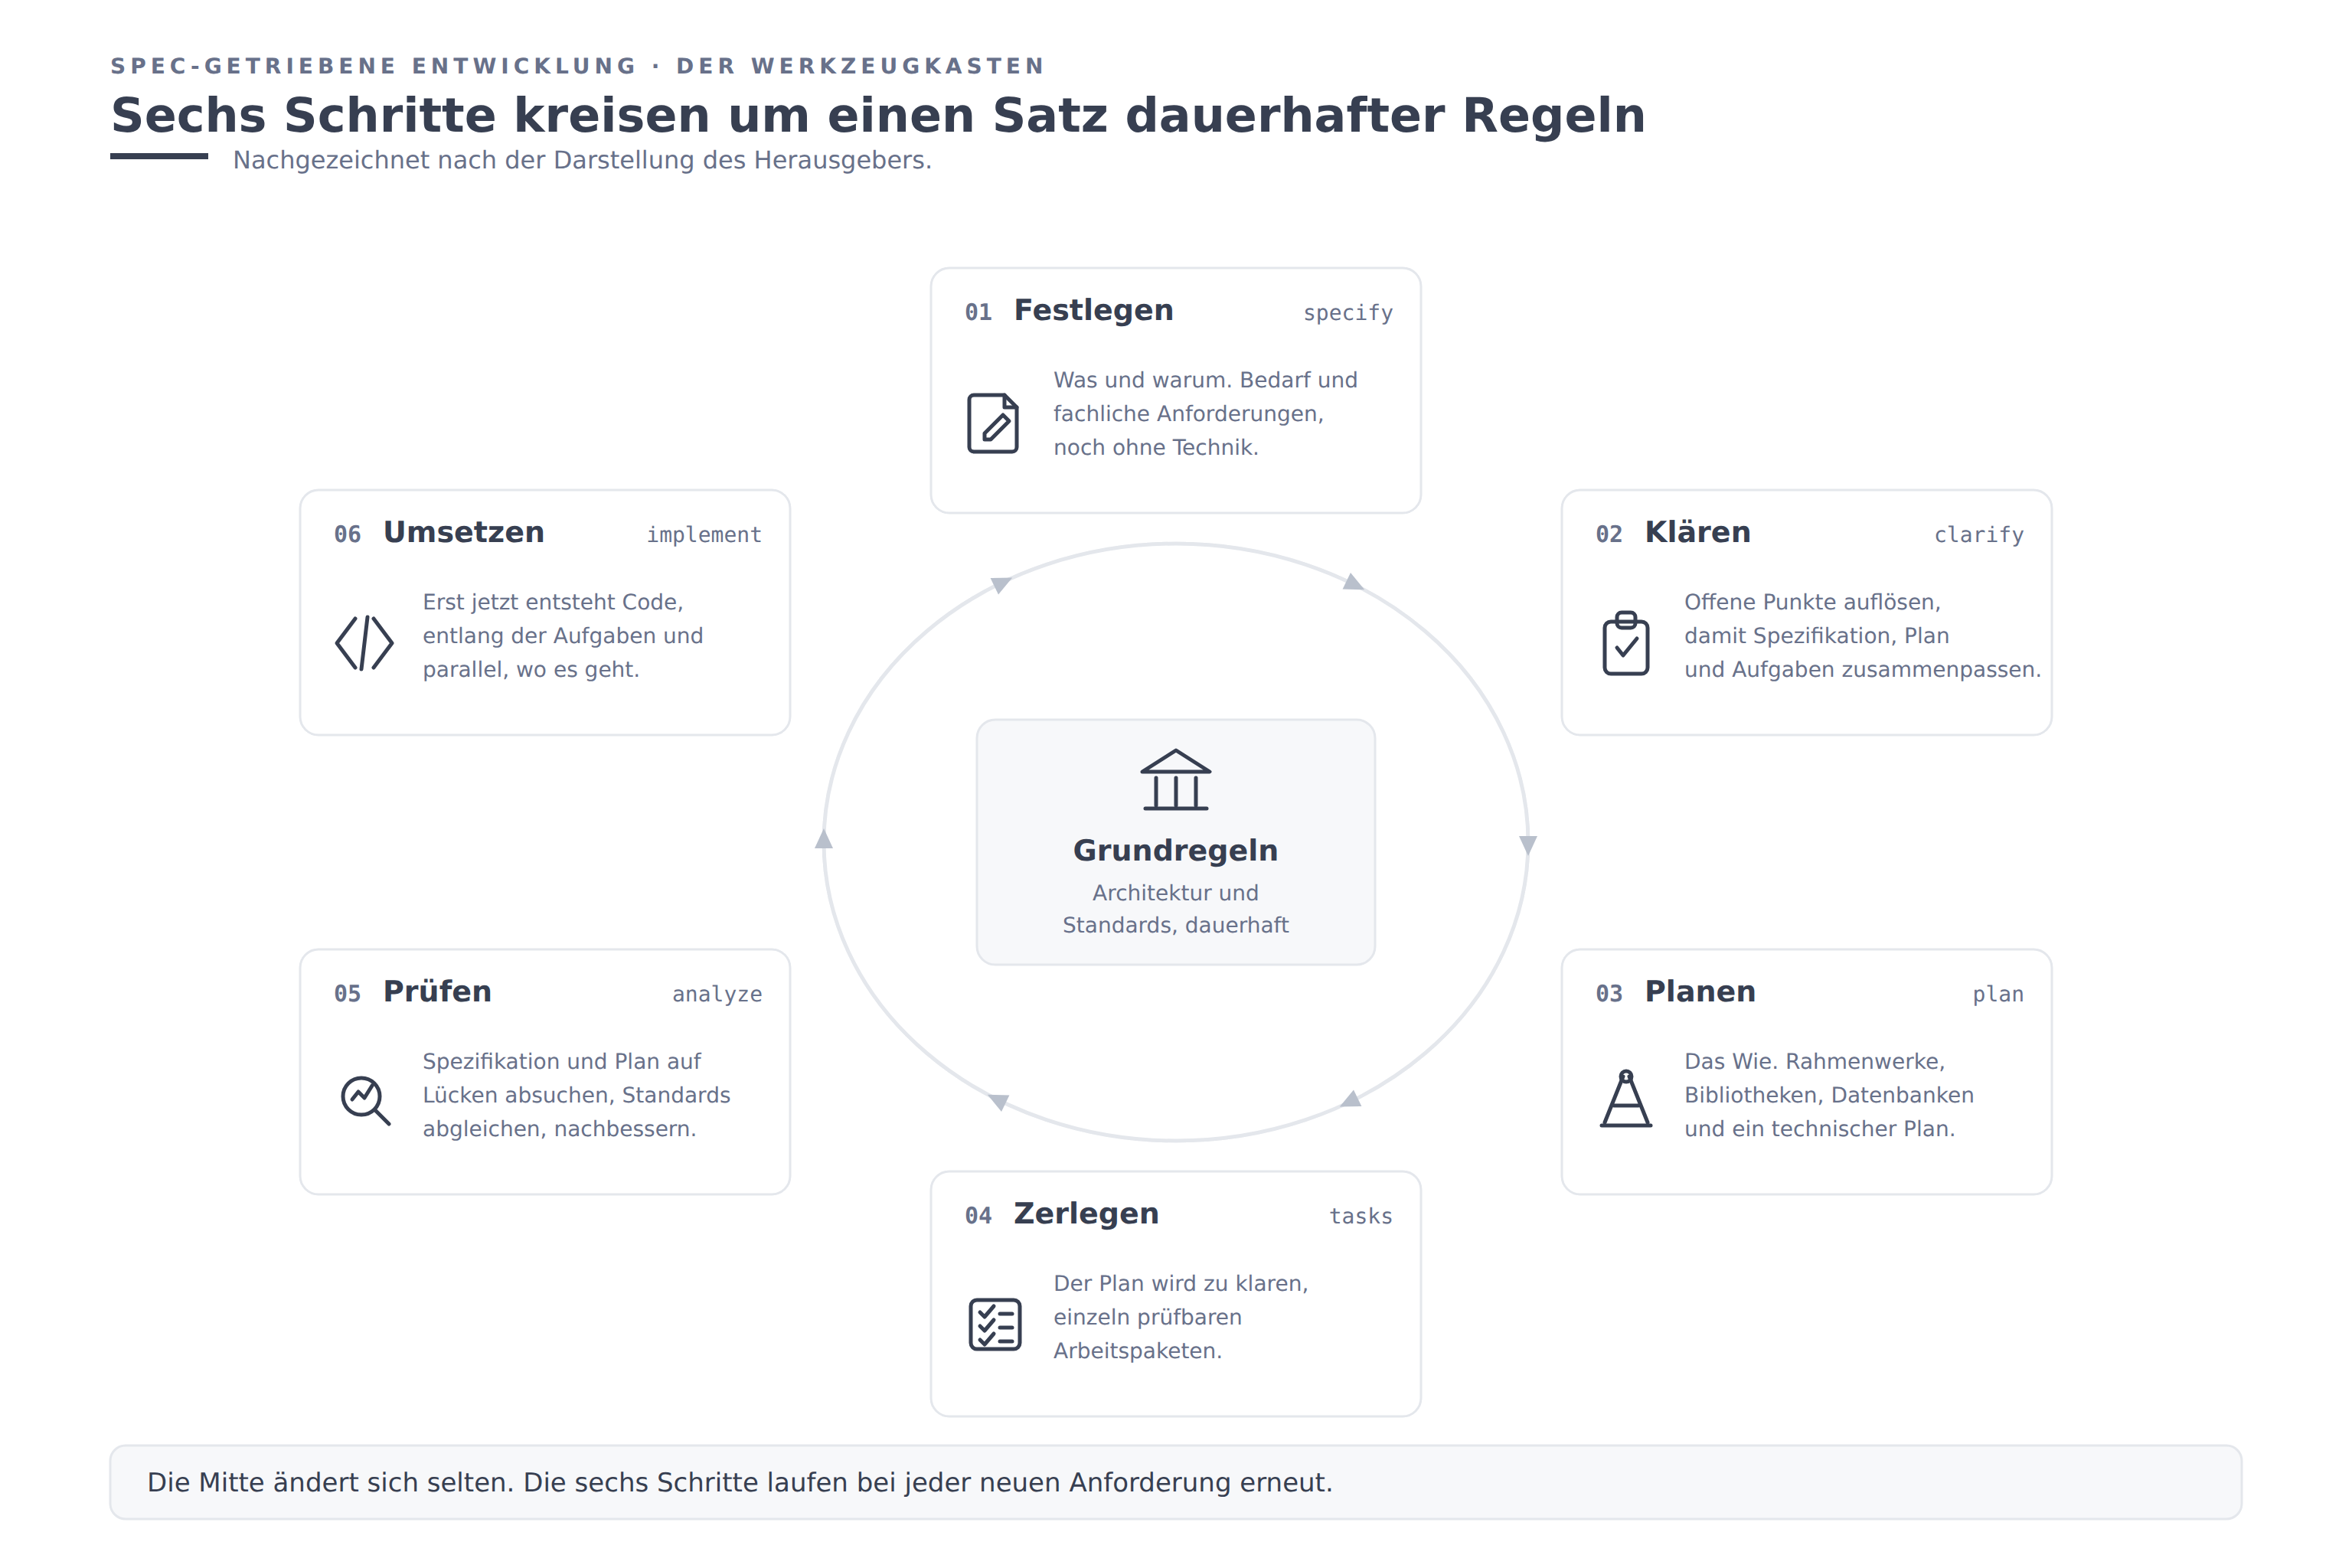
Abbildung 2: Der Arbeitsablauf des Werkzeugkastens [5], im Hausstil nachgezeichnet, basierend auf der Darstellung, die Microsoft in [7] veröffentlicht hat. In der Mitte stehen die dauerhaften Projektregeln. Die sechs Schritte laufen darum herum. Die englischen Phasennamen sind die Befehle, die das Werkzeug wirklich kennt.
Tabelle 3: Die Phasennamen der vier Werkzeugkästen.
| Werkzeug | Phasen in der Benennung des Werkzeugs | Dateien, die bleiben |
|---|---|---|
| Spec Kit [5] | constitution, specify, clarify, plan, tasks, implement | constitution.md, spec.md, plan.md, tasks.md |
| Kiro [6] | requirements, design, tasks | requirements.md, design.md, tasks.md |
| OpenSpec [8] | explore, propose, apply, archive | proposal.md, specs/, archive/ |
| Tessl [11] | sammeln, verfassen, prüfen, nachweisen | eine Spezifikationsdatei je Codedatei |
Jeder von ihnen trennt dieselben vier Bausteine: dauerhafte Projektregeln, das Sollverhalten, den technischen Entwurf und die zerlegten Arbeitseinheiten. Spec Kit [5] und OpenSpec [8] stehen unter der MIT-Lizenz.
Eine Einzelheit lohnt sich, bevor sie einen Nachmittag kostet. Der in [7] beschriebene Lebenszyklus enthält eine Nachweisstufe. Die ausgelieferte Befehlszeile von [5] kennt keinen solchen Befehl. Der Lebenszyklus ist die Erzählung. Das Werkzeug ist das Werkzeug.
4. Die Fallstricke der Arbeitsweise
Die berichteten Schwierigkeiten treten über unabhängige Quellen hinweg so ähnlich auf, dass sie ernst zu nehmen sind.
Übererzeugung. Eine kleine Fehlerbehebung brachte in [4] vier Anwendungsfälle mit sechzehn Abnahmekriterien hervor. Praktiker in einer offenen Diskussion berichteten denselben Effekt unabhängig davon [12].
Prüflast. Wer prüft, liest jetzt Spezifikationsdateien statt Code. [4] nennt die Vorliebe, lieber den Code selbst zu lesen. [13] ergänzt weitschweifige Ausgaben, die die geistige Last erhöhen.
Anweisungswucherung. Der mitgeführte Zusammenhang wächst, bis die Qualität unter dem eigenen Gewicht nachgibt [13]. [14] benennt dasselbe Versagen, dazu ein zweites: das stille Auseinanderlaufen von Spezifikation und Code, unsichtbar, bis es teuer wird.
Abhängigkeit vom Können. Den größten Nutzen ziehen erfahrene Entwickler [13]. Spezifikations-getriebene Entwicklung verstärkt vorhandene Ingenieursdisziplin. Sie ersetzt sie nicht.
Schlechte Passung. [10] bewertet Schnellkorrekturen, erkundende Arbeit und einmalige als schlecht passend. Nicht jede Änderung braucht einen Lebenszyklus. [7] sagt das ebenfalls.
Die unabhängige Einschätzung bleibt nüchtern. Das Technologieradar in [13] stellt die Arbeitsweise auf die Stufe beobachten, nicht auf erproben und nicht auf übernehmen. Die eine strenge Untersuchung mit menschlichen Teilnehmern liegt nur als angemeldetes Vorhaben vor [15]. Ergebnisse hat sie noch keine. Die Arbeitsweise wird deutlich vor ihrer Beleglage übernommen.
5. Der erste Schritt im eigenen Bestand
Fangen Sie mit einer einzigen Funktion an, bei der die Abstimmung sichtbar hakt, nicht mit dem ganzen Bestand.
Spec Kit [5] ist unter der MIT-Lizenz veröffentlicht. Richten Sie es im Projekt ein, dann laufen im Codewerkzeug die Phasen der Reihe nach: constitution, specify, clarify, plan, tasks, implement. Die Einrichtung legt Spezifikationsvorlagen und Befehls-Prompts im Projekt ab; genau diese Vorlagen lohnt es sich zu bearbeiten.
OpenSpec [8], ebenfalls MIT, passt für Teams, die lieber in Änderungen denken als in Dokumenten. Seine Phasen laufen explore, propose, apply, archive. Es erhebt standardmäßig anonyme Nutzungsdaten; die Umgebungsvariable zum Abschalten ist dokumentiert, für Teams unter europäischem Datenschutz ein Pflichtpunkt.
Schreiben Sie die Abnahmekriterien in einer prüfbaren Form. Das Muster aus [6] ist eine Zeile je Regel: Tritt eine Bedingung ein, dann leistet das System eine benannte Sache. Ein Kriterium in dieser Form kann ein Test werden. Ein Absatz Prosa kann das nicht.
5.1 Der Ort der Prüfung
Zwei Begriffe tragen diesen Abschnitt. Beide sind einfacher als ihr Ruf. Ein (englisch hook) ist ein Skript, das die Versionsverwaltung an einer festen Stelle von selbst startet, zum Beispiel vor jeder Übernahme. Ein ist eine Prüfung mit nur zwei Ausgängen, bestanden oder durchgefallen; sperrt den nächsten Schritt.
Das erste Netz kann komplett lokal laufen. Die Spezifikation ist eine Datei, die Gates sind Skripte; ein Haken vor jeder Übernahme fährt die Kette auf dem eigenen Rechner. Auch die Werkzeugkästen oben binden Sie an keine Plattform; sie laufen als Befehlszeilenprogramme im eigenen Bestand, neben jedem Git-Dienst oder ganz ohne einen.
Die ehrliche Grenze sitzt einen Schritt weiter. Eine rein lokale Prüfung lässt sich stillschweigend überspringen, eine serverseitige nicht. Für einen Einzelnen reicht der Haken auf dem eigenen Rechner. Sobald ein Zweiter mitarbeitet, gehört das zweite Netz auf eine Maschine, die keinem Entwickler gehört; das ist der Gedanke der frischen Maschine aus [29] in seiner praktischen Form.
Für eine KI, die Code schreibt, wird diese Anordnung selbst zum Abnahmekriterium. Der Agent muss seine Arbeit hochladen; solange der Server die Annahme verweigert, ist die Arbeit nicht fertig. Fertig ist der Zustand, in dem der Server die Arbeit angenommen hat und jedes Gate meldet.
6. Die Folgerung für Ihre Arbeit
Der gemessene Teil dieses Feldes ist schmal. Er zeigt in eine Richtung: Eine klarere Spezifikation erzeugt besseren Code [1] [2] [3]. Allein das ist schon etwas wert.
Der ungemessene Teil ist das Versprechen, die Arbeitsweise ersetze die Prüfung. Sie tut es nicht. Der häufigste Fehler in [1] waren Aufrufe von Schnittstellen, die es nicht gibt, genau die Art, die ein rein lesendes Prüfprogramm schon gefangen hätte. Verantwortlich dafür ist die Prüfung, nicht die Spezifikation. Gelöst wird es, indem die Prüfung außerhalb des Modells läuft.
Die ehrliche Fassung dieser Arbeitsweise besteht deshalb aus zwei Arbeitsstücken, nicht aus einem. Eine Spezifikation legt das Soll fest. Eine Prüfung läuft danach und meldet das Ist. Die Spezifikation steuert die Erzeugung. Erst die Prüfung entscheidet über das Ergebnis.
7. Quellen
[1] S. Feng, B. Chen, B. H. Meyer und G. Mussbacher, "LLM-Assisted Repository-Level Generation with Structured Spec-Driven Engineering", FSE Companion 2026, arXiv:2605.02455.
[2] H. Jia, R. Morris, H. Ye, F. Sarro und S. Mechtaev, "Automated Repair of Ambiguous Problem Descriptions for LLM-Based Code Generation", arXiv:2505.07270, 2025.
[3] D. Yang, X. Xie, X. Yang, M. Hu, Y. Huang, Y. Zhang, W. Miao, T. Su, C. Wan und G. Pu, "Assessing the Impact of Requirement Ambiguity on LLM-based Function-Level Code Generation", arXiv:2604.21505, 2026.
[4] B. Böckeler, "Understanding Spec-Driven-Development: Kiro, spec-kit und Tessl", martinfowler.com, 2025-10-15. https://martinfowler.com/articles/exploring-gen-ai/sdd-3-tools.html
[5] GitHub, "spec-kit", Softwareablage, MIT-Lizenz, 2026. https://github.com/github/spec-kit
[6] Kiro, "Specs" und "Feature Specs", Produktdokumentation, abgerufen am 2026-08-15. https://kiro.dev/docs/specs/
[7] A. Gupta, "Spec-Driven Development: A Spec-First Approach to AI-Native Engineering", Microsoft for Developers Blog, 2026-06-10. https://developer.microsoft.com/blog/spec-driven-development-ai-native-engineering/
[8] Fission-AI, "OpenSpec", Softwareablage, MIT-Lizenz, 2026. https://github.com/Fission-AI/OpenSpec
[9] DORA und Google Cloud, "State of AI-Assisted Software Development", Branchenbericht, 2025-09-23. https://cloud.google.com/blog/products/ai-machine-learning/announcing-the-2025-dora-report
[10] W. Zhang und J. J. Xia, "Structured-Prompt-Driven Development", martinfowler.com, 2026-04-28. https://martinfowler.com/articles/structured-prompt-driven/
[11] Tessl, "Spec-Driven Development with Tessl", Produktdokumentation, abgerufen am 2026-08-15. https://docs.tessl.io/use/spec-driven-development-with-tessl
[12] Praktiker-Diskussion, "Understanding Spec-Driven-Development", news.ycombinator.com Eintrag 45610996, 2025-10. https://news.ycombinator.com/item?id=45610996
[13] Thoughtworks, "Spec-driven development" und "GitHub Spec Kit", Technology Radar, Stufe beobachten, 2025-11-05. https://www.thoughtworks.com/en-us/radar/techniques/spec-driven-development
[14] H. Grabowski, "The Spec Growth Engine: Spec-Anchored, Code-Coupled, Drift-Enforced Architecture for AI-Assisted Software Development", arXiv:2606.27045, 2026.
[15] G. Rosa, D. Moreno-Lumbreras, G. Robles und J. M. González-Barahona, "Understanding Specification-Driven Code Generation with LLMs: An Empirical Study Design", SANER 2026 angemeldetes Vorhaben, arXiv:2601.03878.
[16] A. Karpathy, "There's a new kind of coding I call vibe coding", Beitrag auf x.com, 2025-02-02. https://x.com/karpathy/status/1886192184808149383
[17] S. E. Farrag, "The Productivity-Reliability Paradox: Specification-Driven Governance for AI-Augmented Software Development", arXiv:2605.01160, 2026.
[18] Y. Liu, R. Widyasari, Z. Zhao, T. G. Irsan, Z. Chen und D. Lo, "Debt Behind the AI Boom: A Large-Scale Empirical Study of AI-Generated Code in the Wild", arXiv:2603.28592, 2026.
[19] M. Duma, K. Wroblewski, A. Bobinska, J. Winiarska und P. Przymus, "These Aren't the Reviews You're Looking For: How Humans Review AI-Generated ", EASE 2026, arXiv:2605.02273.
[20] Veracode, "2025 GenAI Code Security Report", vendor benchmark, 2025. https://www.veracode.com/resources/analyst-reports/2025-genai-code-security-report/
[21] METR, "Measuring the Impact of Early-2025 AI on Experienced Developer Productivity", arXiv:2507.09089, 2025.
[22] M. Borg, D. Hewett, D. Hagatulah, N. Couderc, E. Söderberg, D. Graham, N. Kini und A. Farley, "Echoes of AI: Investigating the Downstream Effects of AI Assistants on Software Maintainability", Empirical Software Engineering, arXiv:2507.00788, 2025.
[23] Y. Zhu, N. Tsantalis und P. C. Rigby, "AI-Generated Smells: An Analysis of Code and Architecture in LLM- and Agent-Driven Development", arXiv:2605.02741, 2026.
[24] A. Karpathy, "Programming via LLM agents is increasingly becoming a default workflow for professionals", Beitrag auf x.com, 2026-02-04, abgerufen über einen Spiegel-Dienst am 2026-08-15. https://x.com/karpathy/status/2019137879310836075
[25] A. Karpathy, "A few random notes from coding with agents", Beitrag auf x.com, 2026-01-26, abgerufen über einen Spiegel-Dienst am 2026-08-15. https://x.com/karpathy/status/2015883857489522876
[26] P. Steinberger, "Just Talk To It, the no-bs Way of Agentic Engineering", steipete.me, 2025-10-14. https://steipete.me/posts/2025/just-talk-to-it
[27] P. Steinberger, "Agentic Engineering und der Weg zur Spezifikation", Videomitschnitt eines Podcast-Gesprächs, 2025. https://www.youtube.com/watch?v=JGxyrPkAKiY
[28] P. Steinberger und L. Fridman, "A conversation with Peter Steinberger", Videomitschnitt eines Podcast-Gesprächs, 2026. https://www.youtube.com/watch?v=YFjfBk8HI5o
[29] P. Steinberger, "Three things that changed my coding", Videomitschnitt eines Vortrags, 2026. https://www.youtube.com/watch?v=82YaJw-_t10