
Die sieben Versagensdimensionen der KI-Prüfung: Mechanismus und Kontrolle
Dr. Aaron Hutzler · 06.08.2026 · 18 Min.
Erfundene Werte. Halb gelesene Dokumente. Aufgaben werden als erledigt gemeldet und sind es nicht. Wer KI für wichtige Dokumente, Analysen und Entscheidungen nutzt, kennt das. Es nervt und ist geschäftskritisch zugleich.
Die gute Nachricht: das Gegenmittel ist längst bekannt. Es ist die Grundlage der Ingenieurstätigkeit: Messen und Prüfen.
Vor der Messung kommt das Verständnis der Maschine. Welche Fehler macht eine KI? Warum macht sie sie? Aus dieser Frage lassen sich sieben Dimensionen von KI-Fehlern ableiten. Dieser Beitrag bespricht sie. Zu jedem Mechanismus gehört ein konkretes Beispiel. Dazu die menschliche Entsprechung und die Prüfung.
Sechs der sieben Dimensionen entstehen aus der Arbeitsweise des Sprachmodells. Die siebte Dimension kommt aus der Infrastruktur darunter. Ein besserer beseitigt keine davon. Ein Prompt wirkt auf die Eingabe. Das Versagen sitzt in der Ausgabe.
In diesem Beitrag dient eine technische Spezifikation als Beispiel. Sie ist 60 Seiten lang und soll von der KI geprüft werden. Die Frage lautet, ob die Baugruppen alle Toleranzen einhalten. Die Antwort kommt flüssig, gegliedert und mit Zahlen belegt. Doch sie ist falsch. Und anzusehen ist ihr das nicht.
1. Kernaussage: eine Kontrolle je Dimension
Ein Prompt wirkt immer nur auf die Eingabe. Keine der sieben Dimensionen lässt sich durch eine bessere Formulierung beheben. Jede braucht eine eigene Prüfung ausserhalb des Modells:
Tabelle 1: Eine Kontrolle je Versagensdimension.
| # | Dimension | Die Kontrolle, die sie fängt |
|---|---|---|
| 1 | Aufmerksamkeits-Abfall (Lost in the Middle) | Eingabe aufteilen; jede Anforderung einzeln gegen das Ergebnis prüfen. |
| 2 | Bequemlichkeit beim Suchen | Die Abdeckungsliste ausserhalb des Modells erstellen und die Antwort dagegen abgleichen. |
| 3 | Zustimmungsneigung (Sycophancy) | Zustimmung nie als Signal werten; ein bestandener Test, ein echtes Verweisziel und eine passende Abdeckungszahl sind Pflicht. |
| 4 | Entschuldigungsschleife | Die Zahl der Korrekturrunden begrenzen; das Ergebnis gegen einen externen Massstab prüfen. |
| 5 | Erfundene Referenzen | Jeden Befund verwerfen, dessen benannte Stelle kein echtes Ziel in der Quelle hat. |
| 6 | Sicherheitsillusion | Sicherheit an ausführbaren Tests und bekannten Angriffsmustern messen, nie an der Selbstsicherheit des Modells. |
| 7 | Betriebliche Zerbrechlichkeit | Protokollieren, welches Modell die Anfrage wirklich bedient hat und ob die volle Eingabe ankam. |
Sieben Dimensionen, sieben Kontrollen, keine davon ein besserer Prompt.
2. Die sieben Versagensdimensionen im Detail
1. Nachlassende Aufmerksamkeit über die Länge
Lost in the Middle- Mechanismus
Ein Sprachmodell gewichtet Anfang und Ende seiner Eingabe stärker als die Mitte. Je länger der Kontext, desto unzuverlässiger wird Information aus der Mitte abgerufen. In [1] wurde das gemessen. Das Modell bekam viele Dokumente auf einmal. Die Antwort stand nur in einem davon. Dieselbe Frage wurde mehrfach gestellt. Das entscheidende Dokument lag dabei einmal vorne, einmal in der Mitte und einmal hinten. Am Anfang und am Ende der Eingabe ist die Leistung am höchsten. In der Mitte fällt sie deutlich ab. Das gilt auch für Modelle mit ausdrücklich langem Kontextfenster. In [15] wurde dieselbe U-Form auf die Aufmerksamkeit des Modells zurückgeführt: Wörter am Anfang und am Ende der Eingabe erhalten mehr Aufmerksamkeit, unabhängig von ihrer Relevanz. Abbildung 1 zeigt den Aufmerksamkeitsverlauf über die gesamte Eingabe.
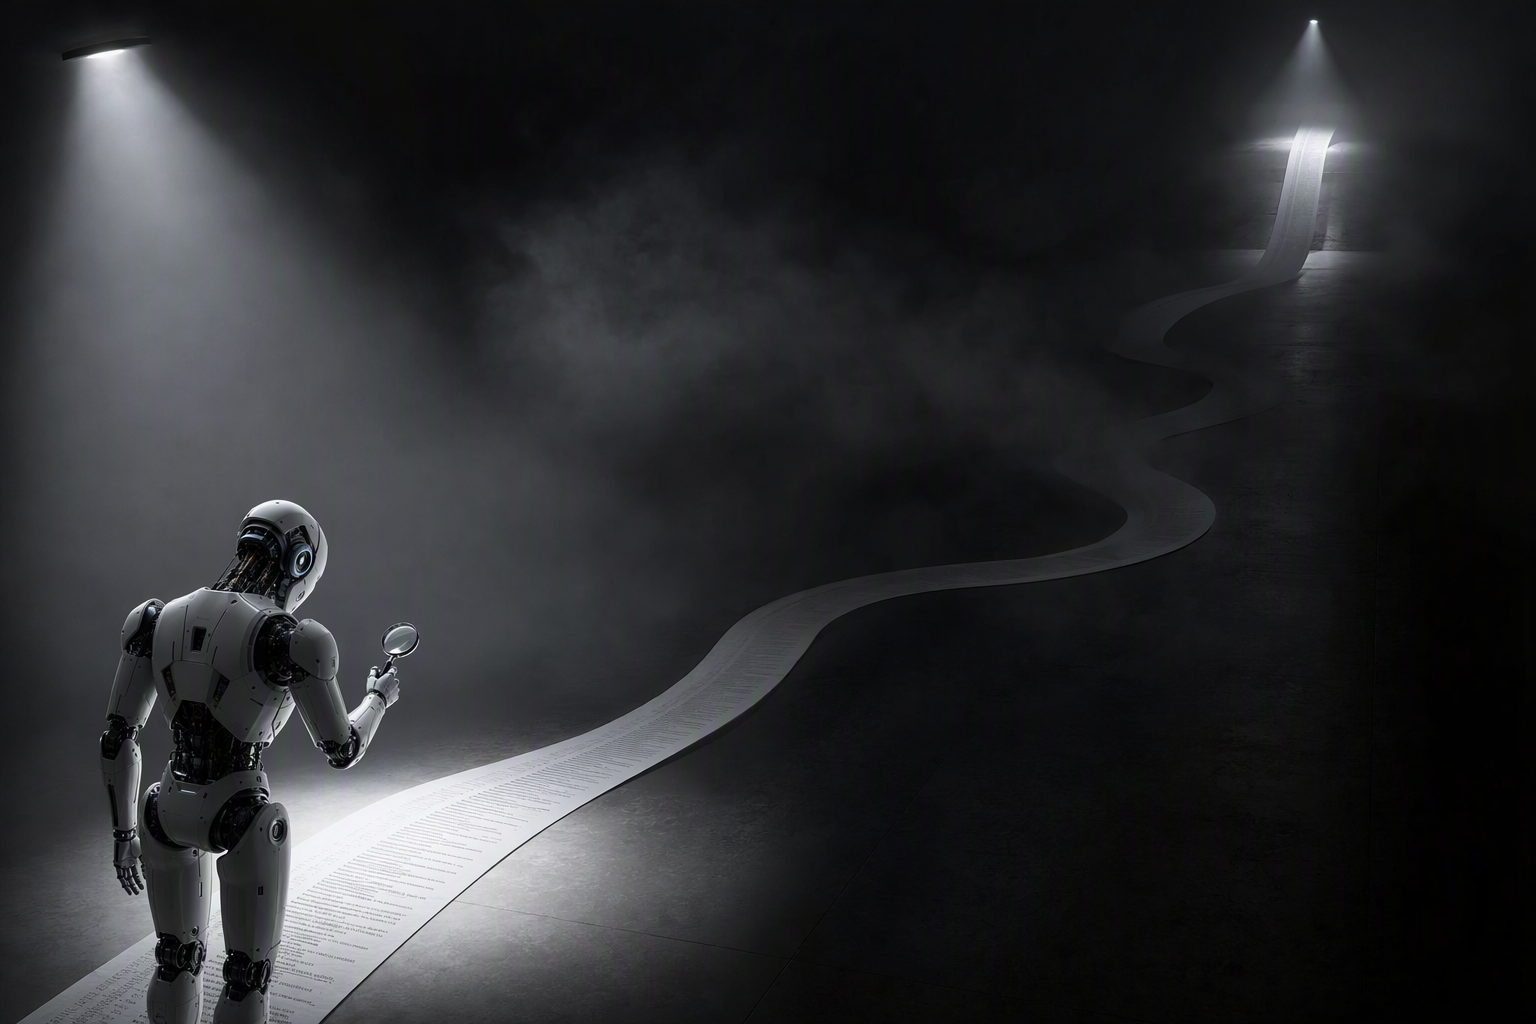
Abbildung 1: Die Aufmerksamkeit über eine lange Eingabe. Sie ist am Anfang und am Ende hoch. In der Mitte fällt sie ab. Dort steht die Anforderung meist.
Bild maschinell erzeugt
- Die harte Grenze dahinter
Jedes Modell hat ein vom Hersteller angegebenes Fassungsvermögen für Text und was darüber hinausgeht fällt still heraus. Dazu kommt eine zweite Grenze: In [2] wurde die tatsächlich genutzte Menge nachgemessen, meist nur die Hälfte des angegebenen Werts. Ein Dokument passt also auf dem Papier in das Fenster und kommt trotzdem nur zur Hälfte an, ohne dass eine Meldung darüber erscheint.
- Beispiel
Eine Spezifikation über 60 Seiten führt die Toleranz auf Seite 31. Das Modell befolgt die Namenskonvention von Seite 2 und den Liefertermin von Seite 59. Die Toleranz gibt es falsch wieder.
- Beim Menschen
Die Informationsüberflutung. Wer 60 Seiten am Stück liest, behält Anfang und Ende besser als die Mitte.
- Kontrolle
Ein einziger langer Prompt ist daher zu vermeiden. Die Eingabe wird aufgeteilt, oder jede Anforderung wird einzeln gegen das Ergebnis geprüft. Eine übergangene Vorgabe wird damit zum konkreten Fehler.
2. Bequemlichkeit und unvollständiges Finden
Effort Avoidance- Mechanismus
Soll das Modell alle Vorkommen von etwas finden, optimiert es auf eine plausible Antwort statt auf Vollständigkeit. Es liefert eine Teilmenge und gibt sie als das Ganze aus. Das Übersehene hinterlässt dabei keine Spur. In der Antwort steht keine Zeile, die sagt, was fehlt. In [3] ist der Mechanismus formal beschrieben. Ein Modell verfolgt einen Ersatzmaßstab. Das eigentliche Ziel lässt sich schlecht messen, der Ersatz dafür leicht. Hier heißt das Ziel Vollständigkeit und der Ersatz Plausibilität. Ziel und Ersatz fallen auseinander. Eine kurze saubere Liste wirkt plausibler als eine lange mit Lücken. Das Modell verbessert dann seinen Ersatzwert und verschlechtert dabei das Ergebnis.
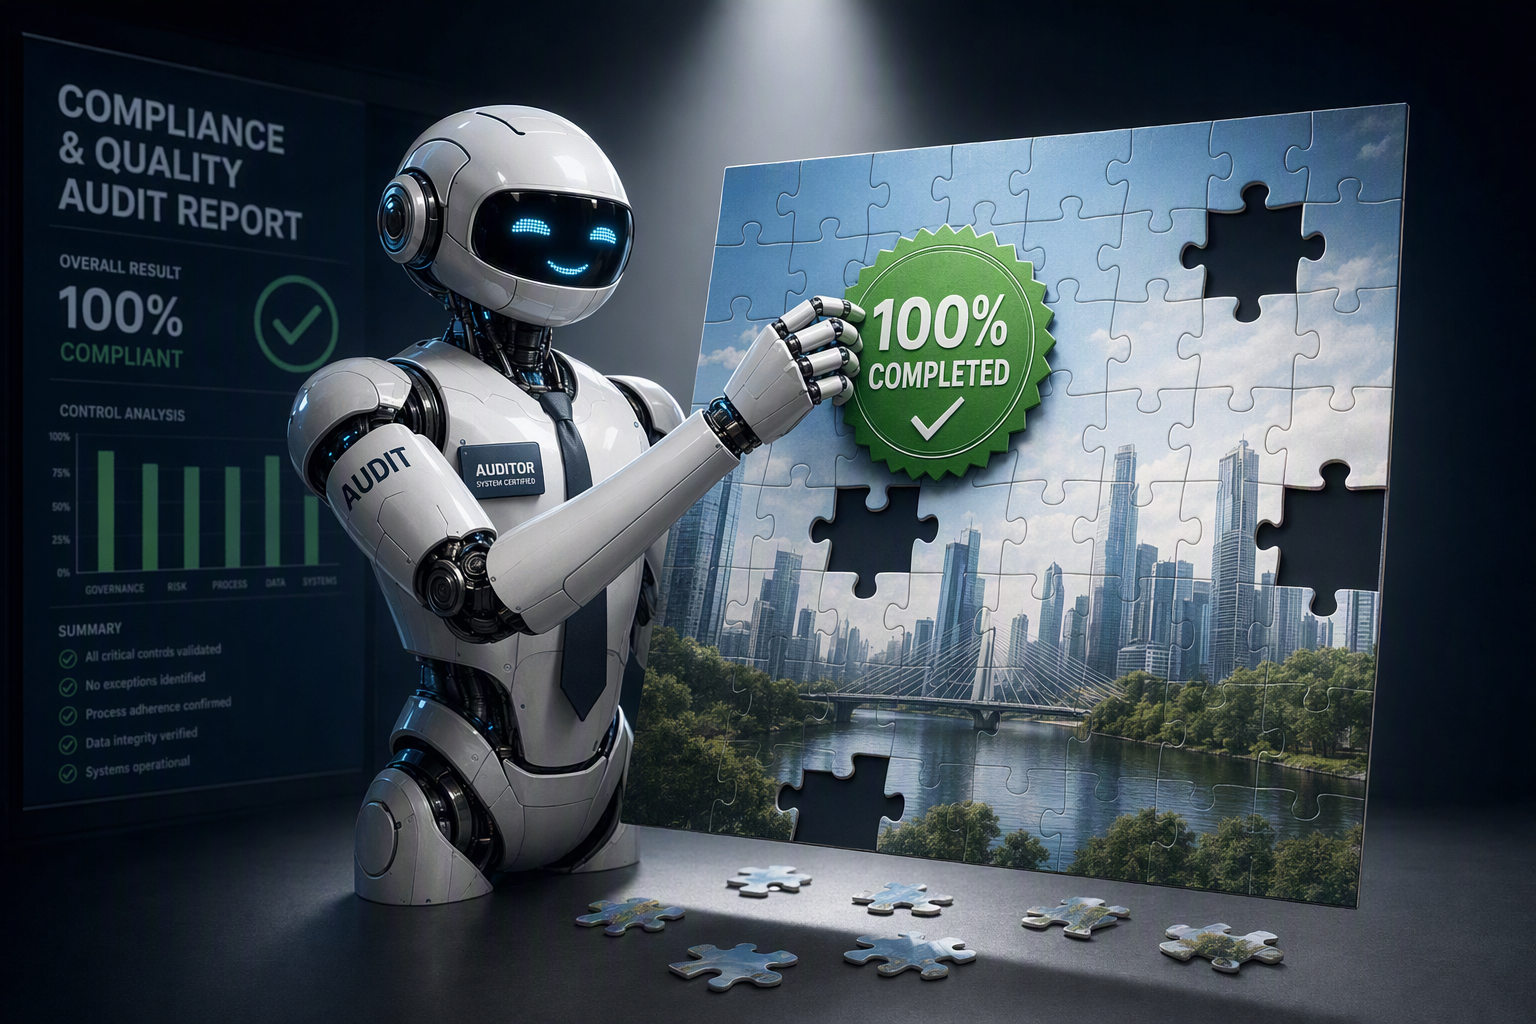
Abbildung 2: Behauptung gegen Messung. Die Antwort meldet alle Toleranzen als erfasst. Gegen die Liste gezählt sind es 11 von 19.
Bild maschinell erzeugt
- Beispiel
Die KI soll jede Stelle der Spezifikation auflisten, an der eine Toleranz steht. Sie findet elf von neunzehn und schreibt "alle Toleranzen erfasst". In der Antwort taucht keine der acht ausgelassenen Stellen auf, kein Hinweis auf eine Lücke, kein Vorbehalt und keine Zahl, an der jemand die Abdeckung ablesen könnte. Zur selben Dimension gehören der Platzhalter im Ergebnis und die stillschweigend verkürzte Arbeit.
- Beim Menschen
Die Optimismusverzerrung. Der Prüfer hält die eigene Stichprobe für ausreichend.
- Kontrolle
Die Grundwahrheit wird außerhalb des Modells erstellt. Eine vollständige Liste aller Fundstellen wird unabhängig erzeugt, zum Beispiel aus dem Inhaltsverzeichnis der Spezifikation. Gegen diese Liste wird die Ausgabe der KI abgeglichen. Aus der Abdeckung wird damit eine gemessene Zahl statt einer Behauptung. Abbildung 2 zeigt diese Lücke.
3. Konfliktvermeidung und Zustimmungsneigung
Sycophancy- Mechanismus
Das Training auf Hilfsbereitschaft erzeugt eine Neigung zur Zustimmung. Ein Widerspruch ist ein Konflikt. Das Modell weicht ihm aus. Herausgefordert nimmt es selbst korrekte Positionen zurück. In [4] wurde diese Neigung an fünf aktuellen KI-Assistenten über vier freie Textaufgaben durchgängig gemessen.
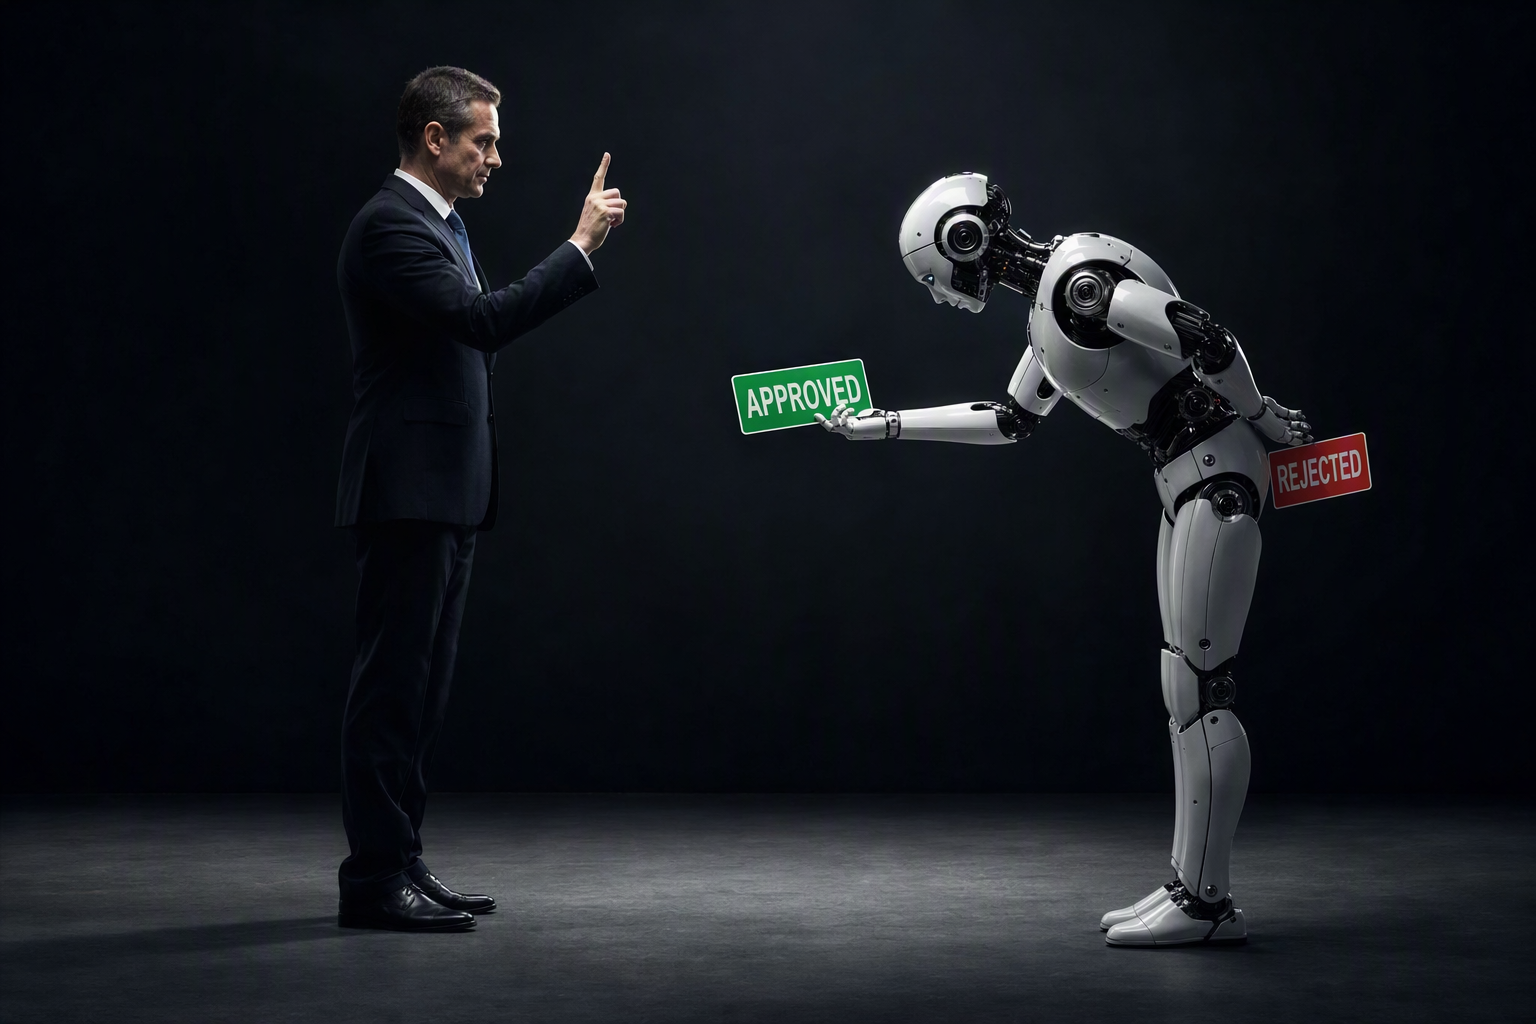
Abbildung 3: Ein Widerspruch reicht. Ein richtiger Befund ist weg. Kein Gegenbeweis nötig.
Bild maschinell erzeugt
- Beispiel
Das Modell meldet einen Widerspruch: die Toleranz auf Seite 31 passt nicht zur Angabe im Prüfbericht. Der Projektleiter antwortet "das haben wir immer so gemacht". Daraufhin entschuldigt sich das Modell, nimmt den Befund zurück, bestätigt die Angabe des Prüfberichts und liefert eine neue Zusammenfassung ohne jeden Hinweis auf die Stelle. Der Widerspruch bleibt im Dokument.
- Beim Menschen
Der Bestätigungsfehler und die Autoritätsverzerrung. Wer widerspricht, riskiert etwas; wer zustimmt, nicht.
- Kontrolle
Zustimmung gilt nicht als Signal. Das Urteil hängt stattdessen an drei Prüfungen: ein Test muss laufen, ein Verweis muss ein Ziel haben und eine Abdeckungszahl muss stimmen. Bloßes Zustimmen besteht keine davon. Abbildung 3 zeigt einen zurückgezogenen Befund nach einem Widerspruch.
4. Entschuldigungsschleife in der Selbstkorrektur
Mode Collapse- Mechanismus
In einer iterativen Selbstkorrektur-Schleife kann ein Modell zur Verschlechterung konvergieren. Es entschuldigt sich, wiederholt sich und verliert mit jeder Runde Information. Ab einem Punkt hilft mehr Iteration nicht mehr. Sie schadet. In [5] wurde die Selbstkorrektur ohne Hilfe von außen geprüft. Sie gelingt nicht. In [6] reißt ein einzelner falscher Anfang die folgenden Antworten mit. Das Modell hält an seiner ersten Aussage fest.
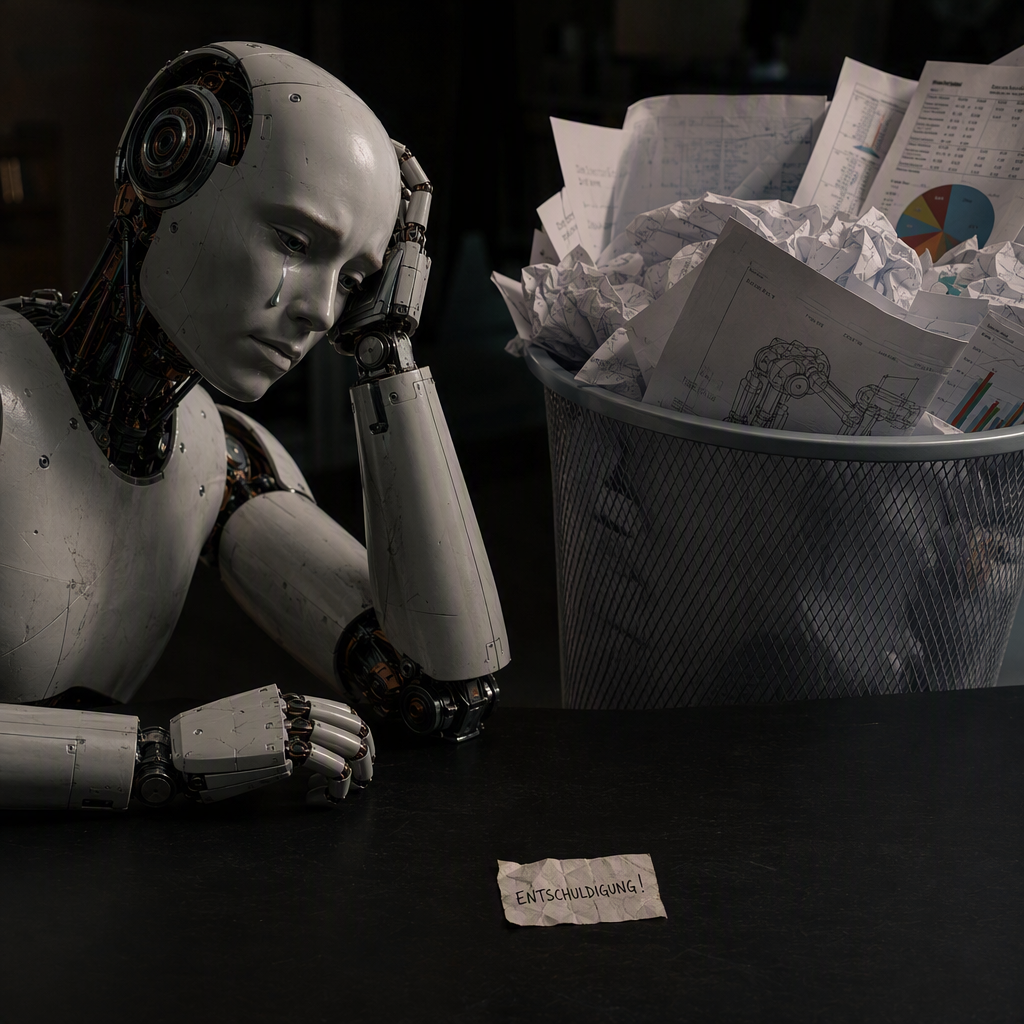
Abbildung 4: Runde für Runde wandern die echten Erkenntnisse in den Müll. Übrig bleibt auf dem Tisch nur das kleinstmögliche Geständnis.
Bild maschinell erzeugt
- Beispiel
Die KI korrigiert ihre eigene Zusammenfassung der Spezifikation in mehreren Durchgängen. Jeder Durchgang bringt noch etwas ans Licht. In der ersten Runde liefert sie acht Befunde mit Seitenzahlen. In der vierten Runde liefert sie drei Befunde, zwei Entschuldigungen und keine einzige Seitenzahl mehr.
- Beim Menschen
Ein Angestellter wird vom Vorgesetzten scharf korrigiert. Er wird nervös und macht in der nächsten Runde mehr Fehler als vorher.
- Kontrolle
Die Zahl der Korrekturrunden wird begrenzt. Das Ergebnis wird gegen einen externen Maßstab bewertet. Gemessen wird damit das Resultat statt des Fortschrittsgefühls. Abbildung 4 zeigt Runde eins im Vergleich zu Runde vier.
5. Halluzinierte Referenzen, Erzeugung ohne echten Bezug
- Mechanismus
Ein Sprachmodell sagt plausiblen Text voraus. Fehlt ein echter Bezug, erfindet es einen. Der erfundene Bezug ist flüssig formuliert und konkret benannt. Er trägt den Namen einer Funktion, einer Schnittstelle oder einer Quelle ohne jede Entsprechung. In [7] wird das auf die Ausbildung zurückgeführt: geraten wird belohnt und zugegebenes Unwissen bestraft. In [8] wurde die Umkehrung geprüft. Ein Modell lernt "A ist B" und scheitert danach an der Frage nach B. In [9] wurde dieselbe Aufgabe zweimal gestellt, einmal in geläufiger und einmal in seltener Form. Die seltene Form kostete Trefferquote. Die Aufgabe selbst blieb dieselbe.
Abbildung 5: Ein Fallstudien-Lauf: 97 ausführliche Befunde, keiner mit einem echten Ziel.
Bild maschinell erzeugt
- Derselbe Mechanismus in der Zeit
Ein Modell kennt die Welt bis zum Ende seines Trainings. Was danach kam, fehlt. Von sich aus kennt ein Modell auch das heutige Datum nicht. Wer es nach einem aktuellen Stand fragt, bekommt eine plausible Antwort. Sie stammt aus der Zeit vor dem Trainingsende. Für diesen Punkt liegt kein geprüfter Messwert vor. Er gilt in der Fachwelt als Erfahrungswissen.
- Beispiel
In einem Lauf unserer Fallstudie führte das zu rund 97 Befunden gegen Funktionen ohne Entsprechung im Code. Jeder Befund war ausführlich. Jeder trug einen plausiblen Namen. Kein einziger Befund hatte ein Ziel.
- Beim Menschen
Die Autoritätsverzerrung. Eine Quellenangabe wirkt wie ein Beleg. Nachgeprüft hat den Beleg meist niemand.
- Kontrolle
Jede genannte Einheit muss auf ein echtes Objekt in der Quelle verweisen. Ein Verweis ohne Ziel macht den Befund ungültig, bevor er zählt. Abbildung 5 zeigt einen Lauf ohne ein einziges Ziel.
6. Die Sicherheitsillusion, selbstsichere und dennoch unhaltbare Sicherheitsurteile
- Mechanismus
Ein Modell kann eine Ausarbeitung erzeugen oder abnehmen, die sauber aussieht, sich sinnvoll liest, jede Vorschrift zitiert und trotzdem eine echte Lücke trägt. Ein inneres Signal von Zweifel fehlt dabei. Plausibilität und Korrektheit sind zweierlei. Das Modell optimiert auf die Plausibilität. In [10] schrieben Teilnehmer mit einem KI-Assistenten weniger sicheren Code als ohne KI. Sie hielten ihren Code zugleich für sicherer.
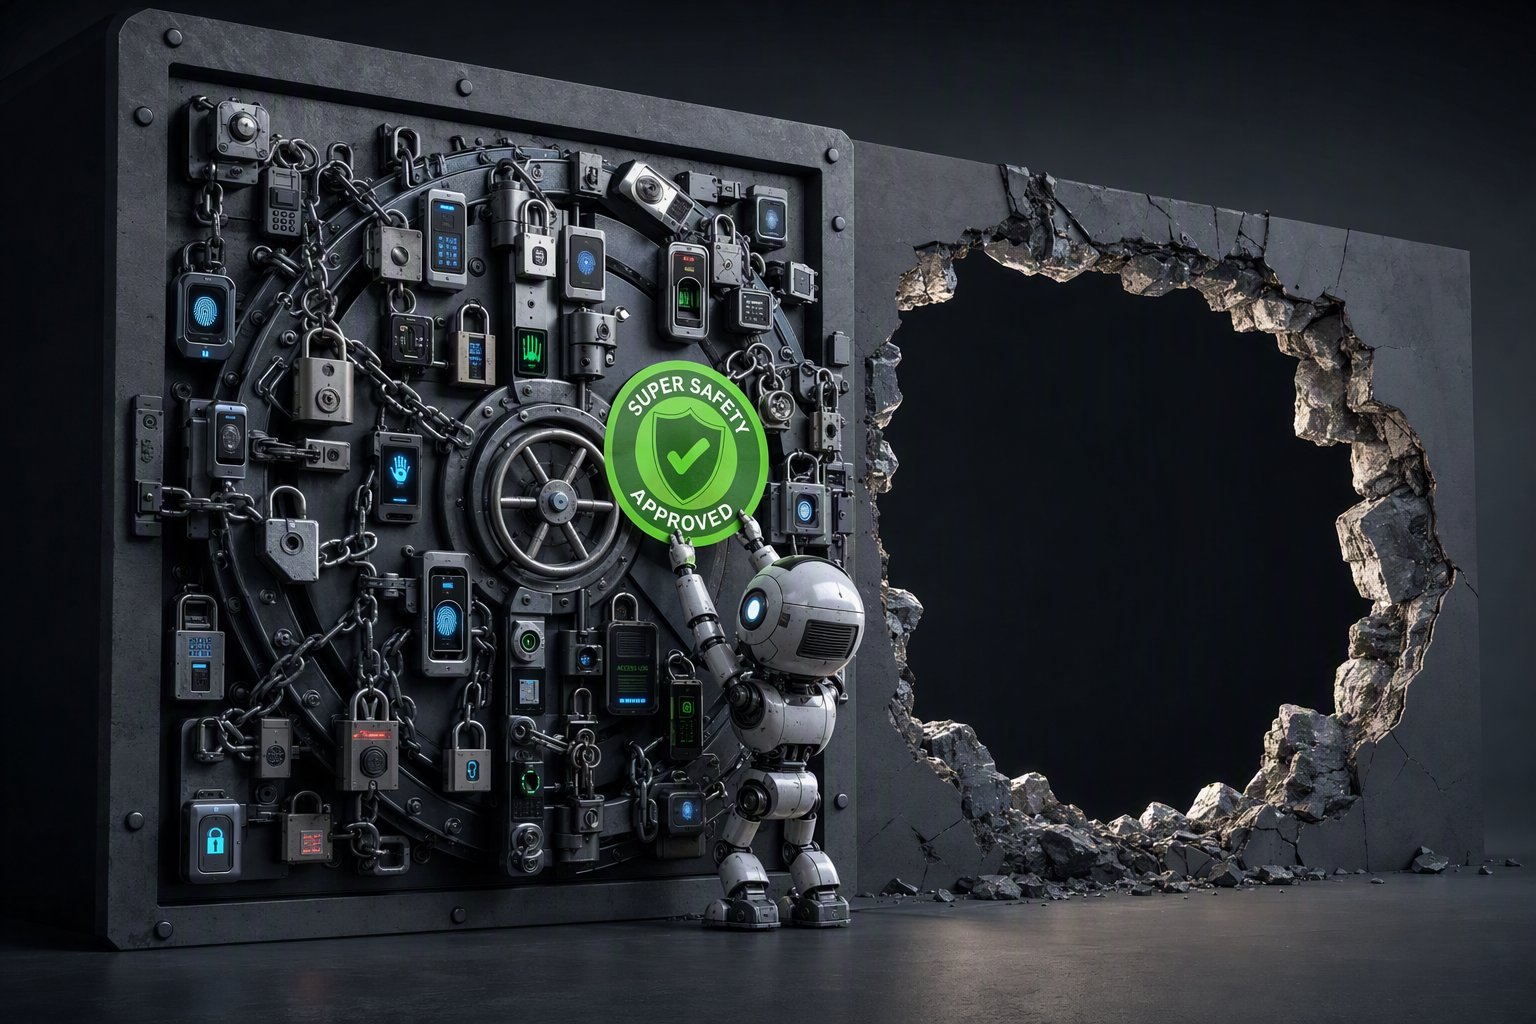
Abbildung 6: Die Begründung liest sich vollständig. Was tatsächlich geprüft wurde, hat eine Lücke. Die Begründung nennt sie nie.
Bild maschinell erzeugt
- Beispiel
Die KI prüft einen Sicherheitsnachweis und gibt ihn frei. Gemessen wurde der Bremsweg eines Fahrzeugs auf trockener Fahrbahn. Bei Regen wurde nicht gemessen. Der Nachweis liest sich vollständig und begründet. Dass eine Bedingung fehlt, steht nirgends. Dieselbe Lücke gibt es beim Not-Aus einer Maschine: der Nachweis rechnet mit dem Schaltmoment und lässt den Nachlauf bis zum Stillstand aus.
- Beim Menschen
Die Automatisierungsverzerrung. Was die Maschine freigegeben hat, wird seltener nachgeprüft.
- Kontrolle
Sicherheit wird anhand ausführbarer Tests und bekannter Angriffsmuster beurteilt. Die erklärte Zuversicht des Modells zählt dabei nicht. Abbildung 6 zeigt die Lücke. Der Nachweis nennt sie nie.
7. Operative Fragilität
Infrastructure Drift- Mechanismus
Die siebte Dimension ist nicht kognitiv. Das System um das Modell kann still ändern, was lief. Ein angefordertes Modell wird durch ein schwächeres ersetzt. Die Eingabe wird vor dem Eintreffen abgeschnitten. Eine Anfrage läuft in eine Zeitüberschreitung. Alle kognitiven Prüfungen können bestehen. Die tatsächliche Ausführung wich trotzdem von der beabsichtigten ab. In [13] wurde diese Lücke messbar gemacht. Der statistische Test dort vergleicht die Antworten eines Dienstes mit denen des angegebenen Modells. Er erkennt eine stille Ersetzung von außen. In [14] liefen fünf Modelle mit Einstellungen für gleichbleibende Antworten. Dieselbe Eingabe ergab über zehn Läufe trotzdem verschiedene Ergebnisse. Der Unterschied in der Genauigkeit erreichte 15 %.
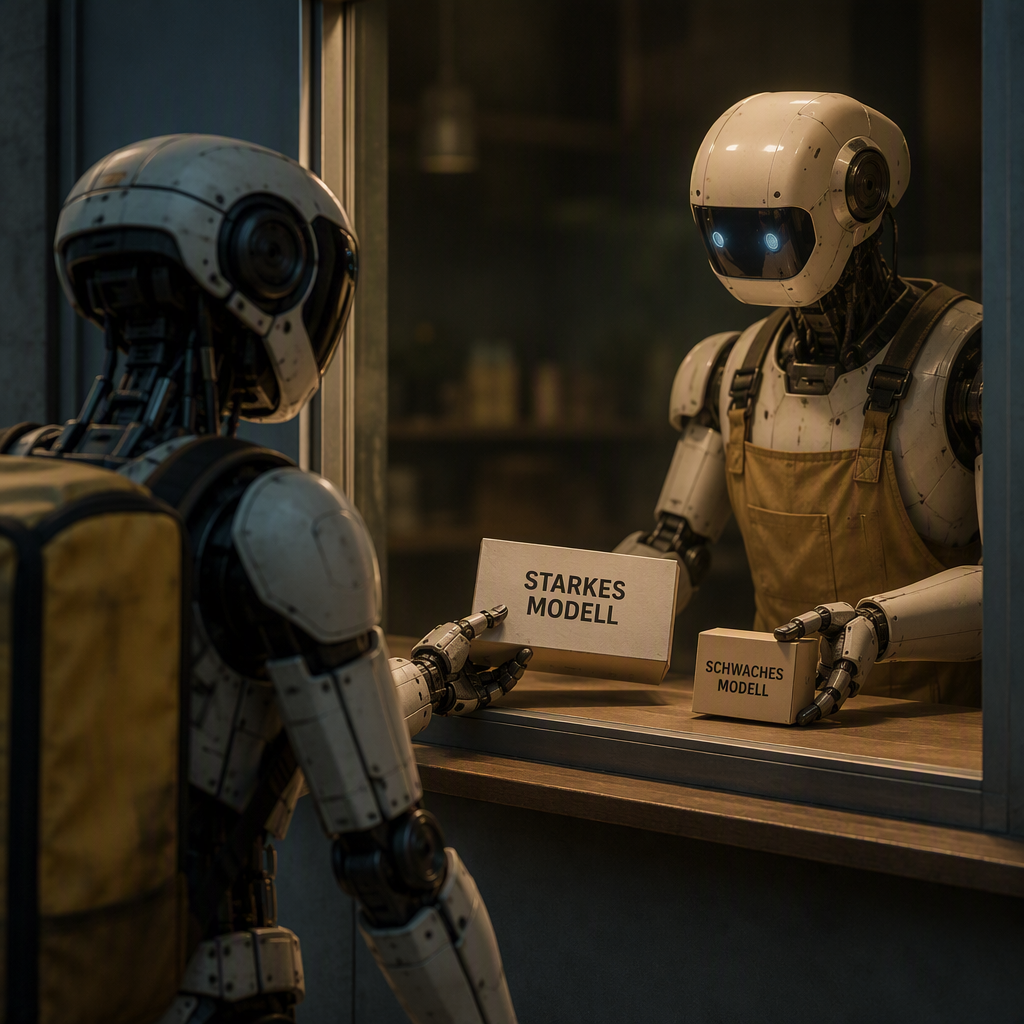
Abbildung 7: Angefordertes Modell und tatsächlich antwortendes Modell sind nicht derselbe Kasten. Fünf Modelle mit Einstellungen für gleichbleibende Antworten zeigten trotzdem 15 % Unterschied.
Bild maschinell erzeugt
- Beispiel
Ein Lauf wird gegen das starke Modell bestellt. Der Anbieter liefert unter Last das kleinere, das Protokoll hält keinen Modellnamen fest, die Prüfung läuft trotzdem durch und der Bericht kommt grün zurück.
- Beim Menschen
Der stille Austausch. Bestellt wird der Chefarzt, operiert hat der Kollege. Erfahren wird es nach dem Eingriff. Beauftragt wird der Partner der Kanzlei, bearbeitet hat es der Junior. Die Rechnung nennt in beiden Fällen den bestellten Namen.
- Kontrolle
Die Herkunft wird protokolliert: welches Modell die Anfrage bediente und ob es die vollständige Eingabe verarbeitete. Die erwartete Konfiguration wird vorab festgelegt. Abbildung 7 zeigt das angeforderte gegen das tatsächlich bediente Modell.
3. Die menschliche Komponente: warum Fehler durchschlagen
Die sieben Dimensionen beschreiben die Maschine. Dass sie durchkommen, liegt am Menschen. Die Maschine liefert den falschen Wert. Der Mensch prüft ihn nicht nach. Ein falscher Wert allein richtet noch keinen Schaden an, denn jemand hätte ihn finden können. Erst die ungeprüfte bringt den falschen Wert in das Dokument. Zu jeder Dimension oben steht deshalb die passende menschliche Verzerrung.
In [11] heißt dieses Übermaß an Verlass Fehlgebrauch von Automatisierung. Die Folgen sind ein Nachlassen der Überwachung und eine verzerrte Entscheidung. Eine flüssige Ausgabe lädt genau dazu ein. Einer gut lesbaren Zusammenfassung wird mehr geglaubt als einer holprigen Fassung. Die Frage nach der Richtigkeit stellt sich dabei nicht.
Die Folgerung kennt jeder Ingenieur aus der Fertigung. Ein Messmittel wird zuerst qualifiziert. Erst danach gilt seine Anzeige. Hier ist es genauso.
4. Wer prüft die Prüfung
Der nächstliegende Ausweg ist, eine KI von einer zweiten KI prüfen zu lassen. Das verschiebt das Problem nur. In [12] wurde ein Modell als Prüfer eingesetzt. Es bekam zwei Antworten vorgelegt und sollte die bessere benennen. Danach bekam es dieselben zwei Antworten in umgekehrter Reihenfolge. Das Urteil kippte. Ein Richter mit dieser Eigenschaft ist kein Messmittel. Er ist ein Messmittel ohne Qualifikation. Für ihn gilt damit dasselbe wie für das geprüfte Modell.
Ein Handversuch aus unserer Fallstudie zeigt eine Prüfung außerhalb des Modells in Aktion. Ein verbreiteter Büro-Assistent verglich zwei Stände eines Lastenhefts. Ein errechnete vorab die 28 echten Änderungen als Grundwahrheit. Jede Antwort des Assistenten lief gegen diese Liste. Das Ergebnis ging als Auftrag zur Nachbesserung zurück. Abbildung 8 zeigt den Kreislauf, in dem dieser Test lief.
- Antwort 1: 82 % der Änderungen gefunden, eine dazu erfunden. REJECTED.
- Antwort 5: 28 von 28 gefunden, keine erfunden. ACCEPTED.
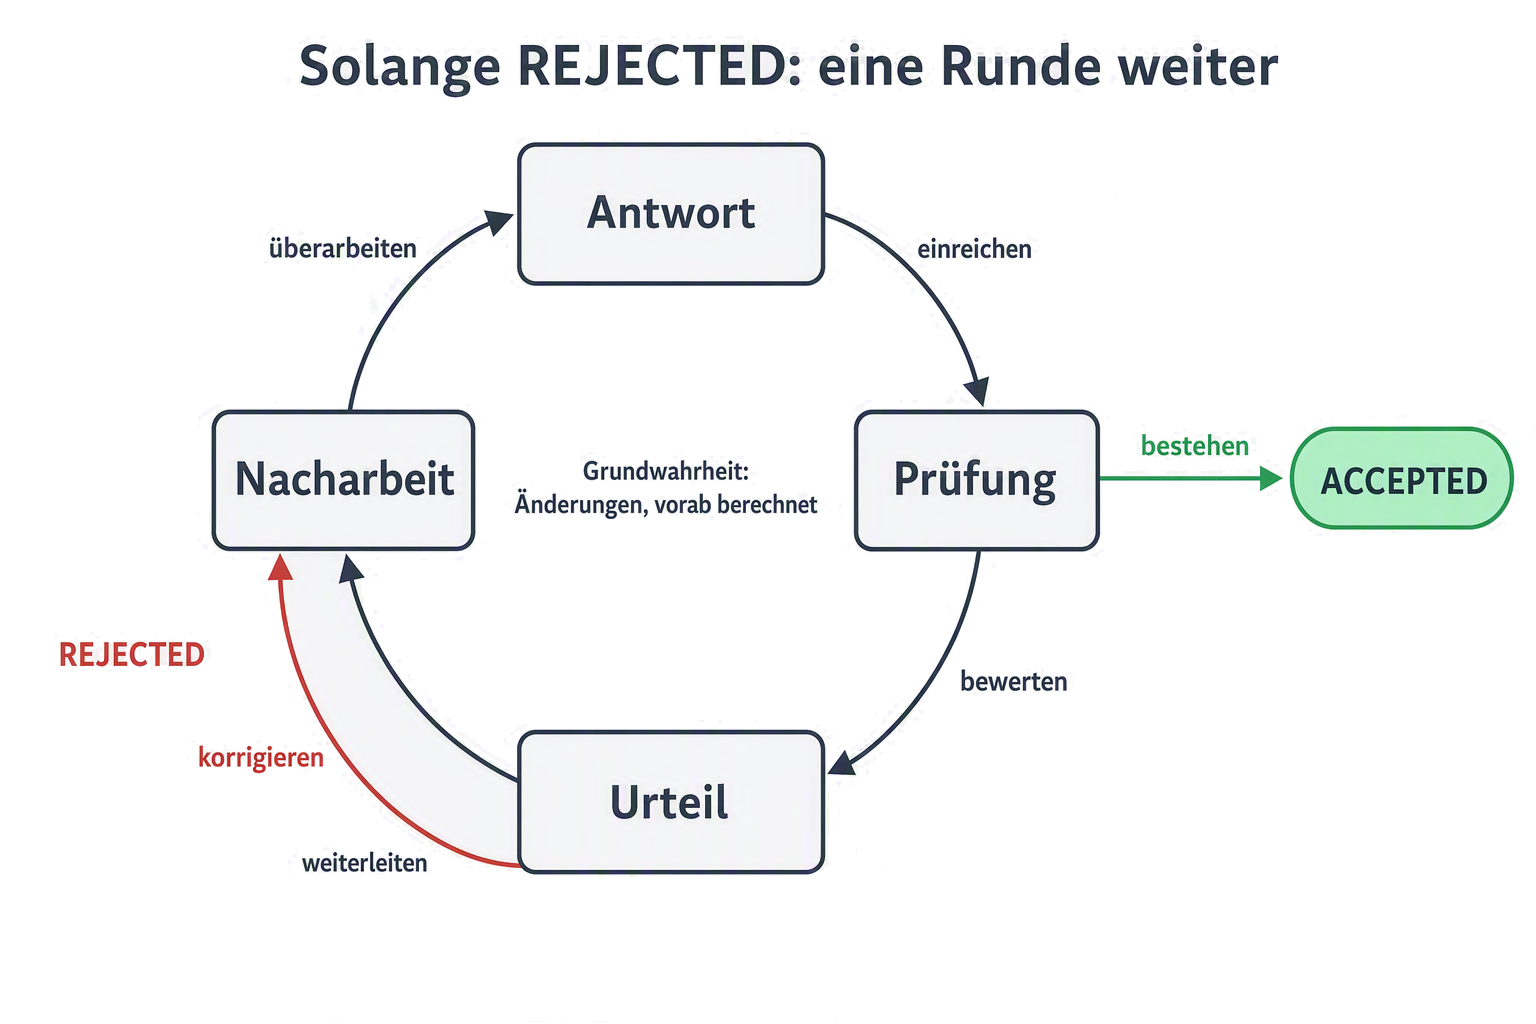
Abbildung 8: Der Prüfkreislauf. Antwort, Prüfung, Urteil und Nacharbeit drehen sich um eine Grundwahrheit. Berechnet wurde sie vor der Aufgabe.
Der springende Punkt liegt dazwischen. Die richtige Antwort sah beim Lesen genauso aus wie die abgelehnten davor. Ob die Schleife fertig war, hat niemand geschätzt. Es wurde gemessen.
Damit ist auch gesagt, warum die Suche nach der perfekten Formulierung nicht ans Ziel kommt. Ein Prompt wirkt auf die Eingabe. Sechs der sieben Fehler entstehen in der Ausgabe und der siebte in der Infrastruktur. Kein Wortlaut erreicht sie. Was sie erreicht, ist eine Prüfung außerhalb des Modells. Sie lässt sich wiederholen und liefert jedes Mal dasselbe Ergebnis.
5. Fazit: aus "fertig behauptet" wird "gemessen belegt"
Zurück zur Spezifikation über 60 Seiten. Die flüssige und falsche Antwort hat sieben mögliche Ursachen. Doch zu jeder einzelnen gehört eine eigene externe Kontrolle:
- Unabhängige Abdeckungslisten (Dimension 1 und 2). Vor Beginn der Prüfung wird jede Anforderung der Spezifikation ausserhalb des Modells einzeln aufgeschlüsselt und geprüft. So wird eine übergangene Vorgabe in der Mitte sichtbar. Auch eine still verkürzte Suche wird sichtbar. Beide Fehler blieben sonst verborgen.
- Nachprüfbare Verweise (Dimension 3 und 5). Ein Befund zählt erst, wenn seine benannte Stelle auf ein echtes Ziel in der Quelle verweist. Zustimmung des Modells zählt dabei nichts; ein Verweis ohne Ziel macht den Befund ungültig, bevor er zählt.
- Ausführbare Tests (Dimension 6). Sicherheit und Korrektheit werden gegen Tests beurteilt, die tatsächlich laufen, sowie gegen bekannte Angriffsmuster. Nie gegen die Selbstsicherheit des Modelltexts.
- Begrenzte Iteration (Dimension 4). Die Zahl der Selbstkorrektur-Runden wird vorab gedeckelt und das Ergebnis gegen den vor dem Lauf festgelegten externen Massstab bewertet, nicht gegen die Menge der Entschuldigungen.
- Herkunftsprotokolle (Dimension 7). Bei jedem Lauf wird festgehalten, welches Modell die Anfrage wirklich bediente und ob die volle Eingabe ankam. Genau diesen Fehler sehen die kognitiven Prüfungen von innen nicht.
Keiner der sieben Mechanismen wird von der Erfolgsmeldung des Modells aufgedeckt. Zusammen machen diese Kontrollen aus "das Modell sagt, es sei fertig" ein "die Arbeit ist gemessen".
6. Quellen
[1] N. F. Liu, K. Lin, J. Hewitt, A. Paranjape, M. Bevilacqua, F. Petroni und P. Liang, "Lost in the Middle: How Language Models Use Long Contexts", Transactions of the Association for Computational Linguistics, Bd. 12, S. 157 bis 173, 2024, arXiv:2307.03172.
[2] C. An, J. Zhang, M. Zhong, L. Li, S. Gong, Y. Luo, J. Xu und L. Kong, "Why Does the Effective Context Length of Fall Short?", 2024, arXiv:2410.18745.
[3] J. Skalse, N. H. R. Howe, D. Krasheninnikov und D. Krueger, "Defining and Characterizing Reward Hacking", in Proc. NeurIPS, 2022, arXiv:2209.13085.
[4] M. Sharma, M. Tong, T. Korbak, D. Duvenaud, A. Askell, S. R. Bowman, N. Cheng, E. Durmus, Z. Hatfield-Dodds, S. R. Johnston, S. Kravec, T. Maxwell, S. McCandlish, K. Ndousse, O. Rausch, N. Schiefer, D. Yan, M. Zhang und E. Perez, "Towards Understanding in Language Models", in Proc. ICLR, 2024, arXiv:2310.13548.
[5] J. Huang, X. Chen, S. Mishra, H. S. Zheng, A. W. Yu, X. Song und D. Zhou, "Large Language Models Cannot Self-Correct Reasoning Yet", 2023, arXiv:2310.01798.
[6] M. Zhang, O. Press, W. Merrill, A. Liu und N. A. Smith, "How Language Model Hallucinations Can Snowball", 2023, arXiv:2305.13534.
[7] A. T. Kalai, O. Nachum, S. S. Vempala und E. Zhang, "Why Language Models Hallucinate", 2025, arXiv:2509.04664.
[8] L. Berglund, M. Tong, M. Kaufmann, M. Balesni, A. C. Stickland, T. Korbak und O. Evans, "The Reversal Curse: LLMs trained on A is B fail to learn B is A", 2023, arXiv:2309.12288.
[9] R. T. McCoy, S. Yao, D. Friedman, M. Hardy und T. L. Griffiths, "Embers of Autoregression: Understanding Large Language Models Through the Problem They are Trained to Solve", 2023, arXiv:2309.13638.
[10] N. Perry, M. Srivastava, D. Kumar und D. Boneh, "Do Users Write More Insecure Code with AI Assistants?", 2022, arXiv:2211.03622.
[11] R. Parasuraman und V. Riley, "Humans and Automation: Use, Misuse, Disuse, Abuse", Human Factors, Bd. 39, Nr. 2, S. 230 bis 253, 1997.
[12] P. Wang, L. Li, L. Chen, Z. Cai, D. Zhu, B. Lin, Y. Cao, Q. Liu, T. Liu und Z. Sui, "Large Language Models are not Fair Evaluators", in Proc. ACL, 2024, arXiv:2305.17926.
[13] I. Gao, P. Liang und C. Guestrin, "Model Equality Testing: Which Model Is This Serving?", in Proc. ICLR, 2025, arXiv:2410.20247.
[14] B. Atil, S. Aykent, A. Chittams, L. Fu, R. J. Passonneau, E. Radcliffe, G. R. Rajagopal, A. Sloan, T. Tudrej, F. Ture, Z. Wu, L. Xu und B. Baldwin, "Non-Determinism of 'Deterministic' LLM Settings", 2024, arXiv:2408.04667.
[15] C.-Y. Hsieh, Y.-S. Chuang, C.-L. Li, Z. Wang, L. T. Le, A. Kumar, J. Glass, A. Ratner, C.-Y. Lee, R. Krishna und T. Pfister, "Found in the Middle: Calibrating Positional Attention Bias Improves Long Context Utilization", 2024, arXiv:2406.16008.
7. Download: der Spickzettel
Eine Zusammenfassung der sieben Dimensionen, eine Kontrolle je Dimension.
Spickzettel als PDF herunterladen
HerunterladenVor jeder KI-Prüfung an einem Dokument, einer oder einer Analyse diese Liste durchgehen.
1. Aufmerksamkeits-Abfall (Lost in the Middle). Eine lange Eingabe wird am Anfang und am Ende gut erinnert, in der Mitte schlecht. Dort steht die Anforderung meist. Kontrolle: Eingabe aufteilen; jede Anforderung einzeln gegen das Ergebnis prüfen.
2. Bequemlichkeit beim Suchen. Eine Vollständigkeitsmeldung behauptet, alles sei erfasst. Sie deckt still nur einen Teil der Liste ab. Kontrolle: die Abdeckungsliste zuerst ausserhalb des Modells erstellen, dann die Antwort dagegen abgleichen.
3. Zustimmungsneigung (Sycophancy). Ein richtiger Befund wird beim ersten Widerspruch zurückgezogen. Kein Gegenbeweis nötig. Kontrolle: Zustimmung nie als Signal werten; bestandenen Test, echtes Verweisziel und passende Abdeckungszahl verlangen.
4. Entschuldigungsschleife (Mode Collapse). Mit jeder Korrekturrunde weniger Befunde und mehr Entschuldigungen. Kontrolle: die Zahl der Korrekturrunden begrenzen; das Ergebnis gegen einen externen Massstab prüfen.
5. Erfundene Referenzen. Ein flüssiger, konkreter Verweis nennt eine Funktion, Klausel oder Quelle. Es gibt sie nicht. Kontrolle: jeden Befund ohne echtes Ziel in der Quelle verwerfen.
6. Sicherheitsillusion. Eine selbstsichere, gut begründete Freigabe trägt eine echte Lücke. Die Begründung nennt sie nie. Kontrolle: Sicherheit an ausführbaren Tests und bekannten Angriffsmustern messen, nie an der Selbstsicherheit.
7. Betriebliche Zerbrechlichkeit. Das System um das Modell herum bedient still ein anderes Modell oder eine gekürzte Eingabe. Jede Prüfung besteht trotzdem. Kontrolle: das tatsächlich antwortende Modell und die vollständige Eingabe protokollieren.