
Warum auch Ergebnisse von Reasoning-Modellen überprüft werden müssen
Dr. Aaron Hutzler · 19.08.2026 · 9 Min.
Seit 2024 werben die großen Anbieter für Modelle mit sichtbarem Denkprozess. Diese Modelle zerlegen die Aufgabe in Schritte, wägen ab und korrigieren sich unterwegs. Die Ergebnisse auf Prüfungsaufgaben sind beachtlich. Daraus wächst ein verführerischer Schluss: Wer nachdenkt, prüft sich selbst. Also kann die Kontrolle entfallen.
Die veröffentlichte Forschung sagt etwas anderes. Drei Befunde tragen das Argument.
1. Die beste gemeldete Trefferquote liegt bei 74,4 % der Aufgaben
Das Denkmodell der ersten Generation löste auf der amerikanischen Mathematik-Olympiade-Qualifikation AIME 2024 74,4 % der Aufgaben [4]. Das Vorgängermodell ohne Denkprozess löste rund 12 % der Aufgaben. Auf der Wettbewerbs-Plattform Codeforces erreichte das Denkmodell das 89. Perzentil.
Beides sind echte Fortschritte und beides sind Wahrscheinlichkeiten. 74,4 % gelöste Aufgaben heißt: Eine von vier Aufgaben geht schief. Das 89. Perzentil heißt: Elf von hundert menschlichen Teilnehmern rechnen besser. Keine der beiden Zahlen bedeutet lauter richtige Antworten und der Hersteller behauptet das auch nirgends. Die Garantie entsteht erst im Kopf des Lesers: Er macht aus "denkt nach" ein "prüft sich".
Ein zweiter Befund aus derselben Quelle wiegt schwerer. In der Systemkarte vom April 2025 [5] testete der Hersteller seine neueren Denkmodelle mit zwei Faktenfrage-Tests. Das Modell der dritten Generation halluzinierte auf dem Personenfragen-Test in 33 % der Fälle. Sein Vorgänger halluzinierte auf denselben Fragen in 16 % der Fälle. Auf dem Kurzfaktentest kam das neue Modell auf 51 % falsche Antworten. Mehr Denkschritte erzeugen mehr Behauptungen. Mit den richtigen wachsen die falschen mit. Der Denkprozess ist ein Verstärker und kein Filter. Abbildung 1 stellt die drei Werte nebeneinander.
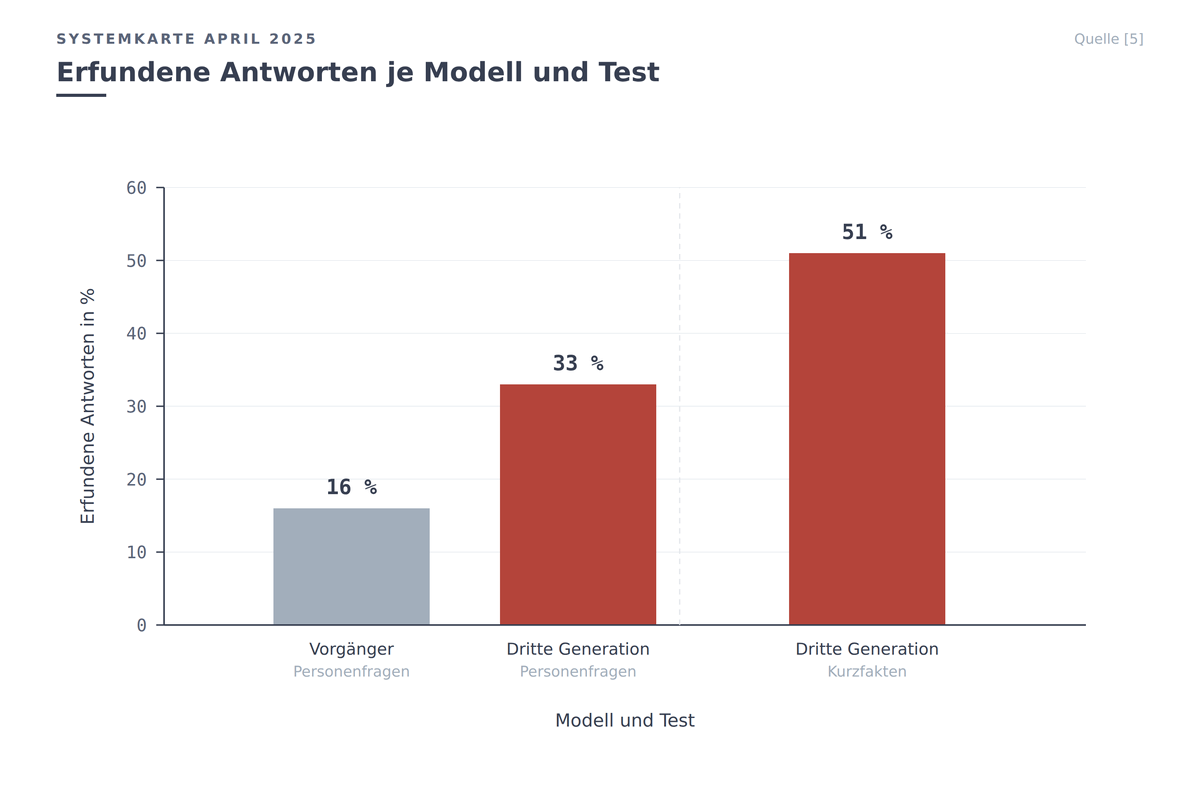
Abbildung 1: Erfundene Antworten je Modell und Test.
2. Die Selbstkorrektur ohne Hilfe von außen scheitert
Forscher eines großen KI-Labors prüften den Fall ohne äußere Rückmeldung: Das Modell überarbeitet seine eigene Antwort aus eigener Kraft [1]. Die Leistung sinkt im Mittel. Das Modell verwirft richtige Antworten genauso bereitwillig wie falsche. Es beurteilt beide mit demselben Apparat. Genau dieser Apparat erzeugte den Fehler. Eine zweite Gruppe zeigte denselben Effekt an Graphenfärbe-Aufgaben [2]. Das Modell löst die Aufgaben schlecht. Es beurteilt fremde Lösungen genauso schlecht. In der Schleife aus Erzeugen und Selbstkritik war der Inhalt der Kritik für das Ergebnis nahezu belanglos. Die Nachfolgearbeit [3] maß zusätzlich viele falsche Freigaben des modellinternen Prüfers: Er nickte Lösungen ab und ein formaler Prüfer verwarf dieselben Lösungen.
Dazu kommt ein Ergebnis zu den sichtbaren Gedankenketten selbst. Eine Untersuchung von 2025 [7] verglich das Denkprotokoll der Modelle mit den tatsächlichen Einflüssen auf die Antwort. In den meisten Konstellationen legte das Protokoll den wahren Grund in unter 20 % der geprüften Fälle offen. Wer die Gedankenkette liest, liest einen nachträglichen Bericht.
Die Rückfrage an das Modell nach seiner eigenen Sicherheit ist deshalb keine Prüfung. Sie befragt denselben Mechanismus und der hat den Fehler gemacht. Die Antwort ist mit hoher Wahrscheinlichkeit ein selbstbewusstes Ja.
3. Was trägt: Prüfung außerhalb des Modells
Dieselbe Forschung zeigt die Lösung. Verbesserungen entstehen erst mit Rückmeldung aus einer äußeren Quelle wie einem Testlauf, einem Rechner, einem formalen Prüfer oder einer Wissensbasis [1]. Der LLM-Modulo-Rahmen [3] macht daraus eine Architektur: Das Modell entwirft Kandidaten und ein Prüfer außerhalb des Modells akzeptiert oder verwirft sie.
Wie groß der Effekt ist, steht in den Zahlen [6]. Ein damals älteres Modell löste im Direktversuch 48,1 % der Aufgaben des Programmier-Benchmarks HumanEval. Das damals beste Modell löste 67,0 % der Aufgaben. Dasselbe ältere Modell in einer Schleife aus Schreiben, Testen und Nachbessern löste 95,1 % der Aufgaben. Die Architektur brachte 47 Prozentpunkte gelöster Aufgaben. Die Modellgeneration brachte 19 Prozentpunkte. Abbildung 2 stellt die drei Anordnungen nebeneinander.
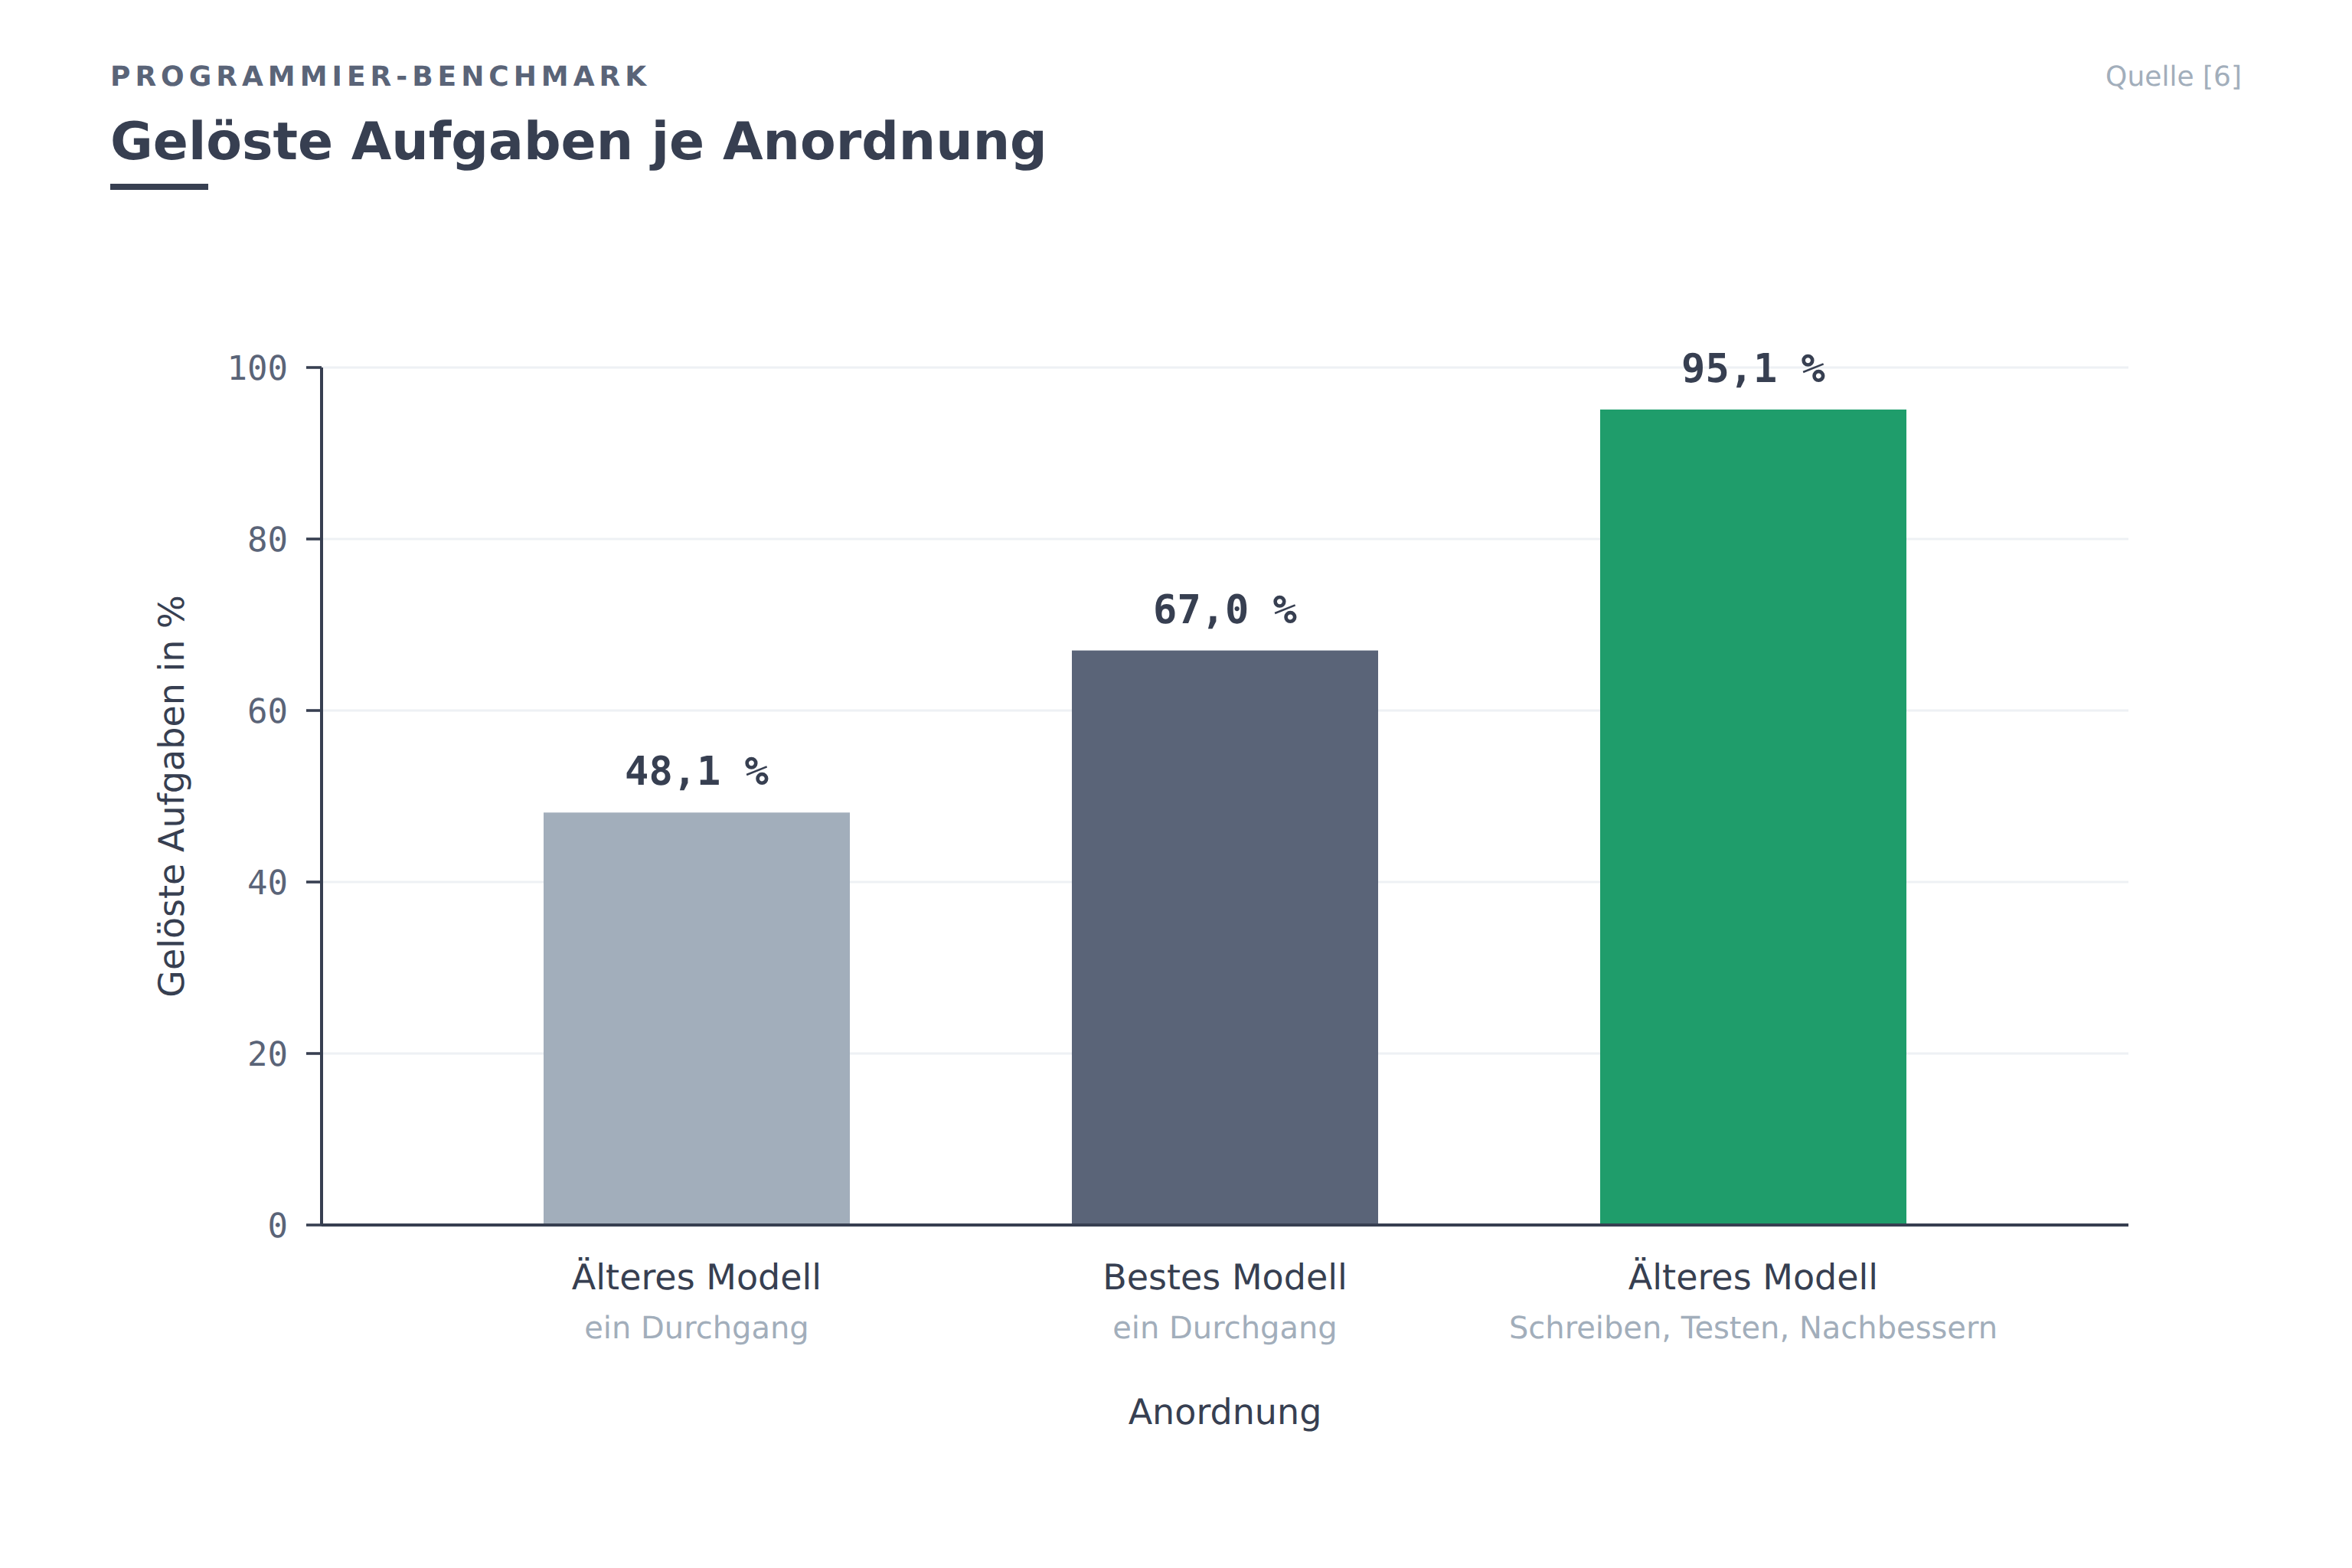
Abbildung 2: Gelöste Aufgaben je Anordnung.
Tabelle 1: Was jede Seite über eine Antwort zusichern kann.
| Eigenschaft der Antwort | Denkmodell | Quality Gate |
|---|---|---|
| Findet einen plausiblen Weg zur Antwort | belegt | erfunden |
| Legt die Zwischenschritte offen | belegt | erfunden |
| Sagt, ob die Zahl im Dokument steht | erfunden | belegt |
| Sagt Nein, wenn der Wert fehlt | erfunden | belegt |
| Hält dasselbe Urteil über mehrere Läufe | erfunden | belegt |
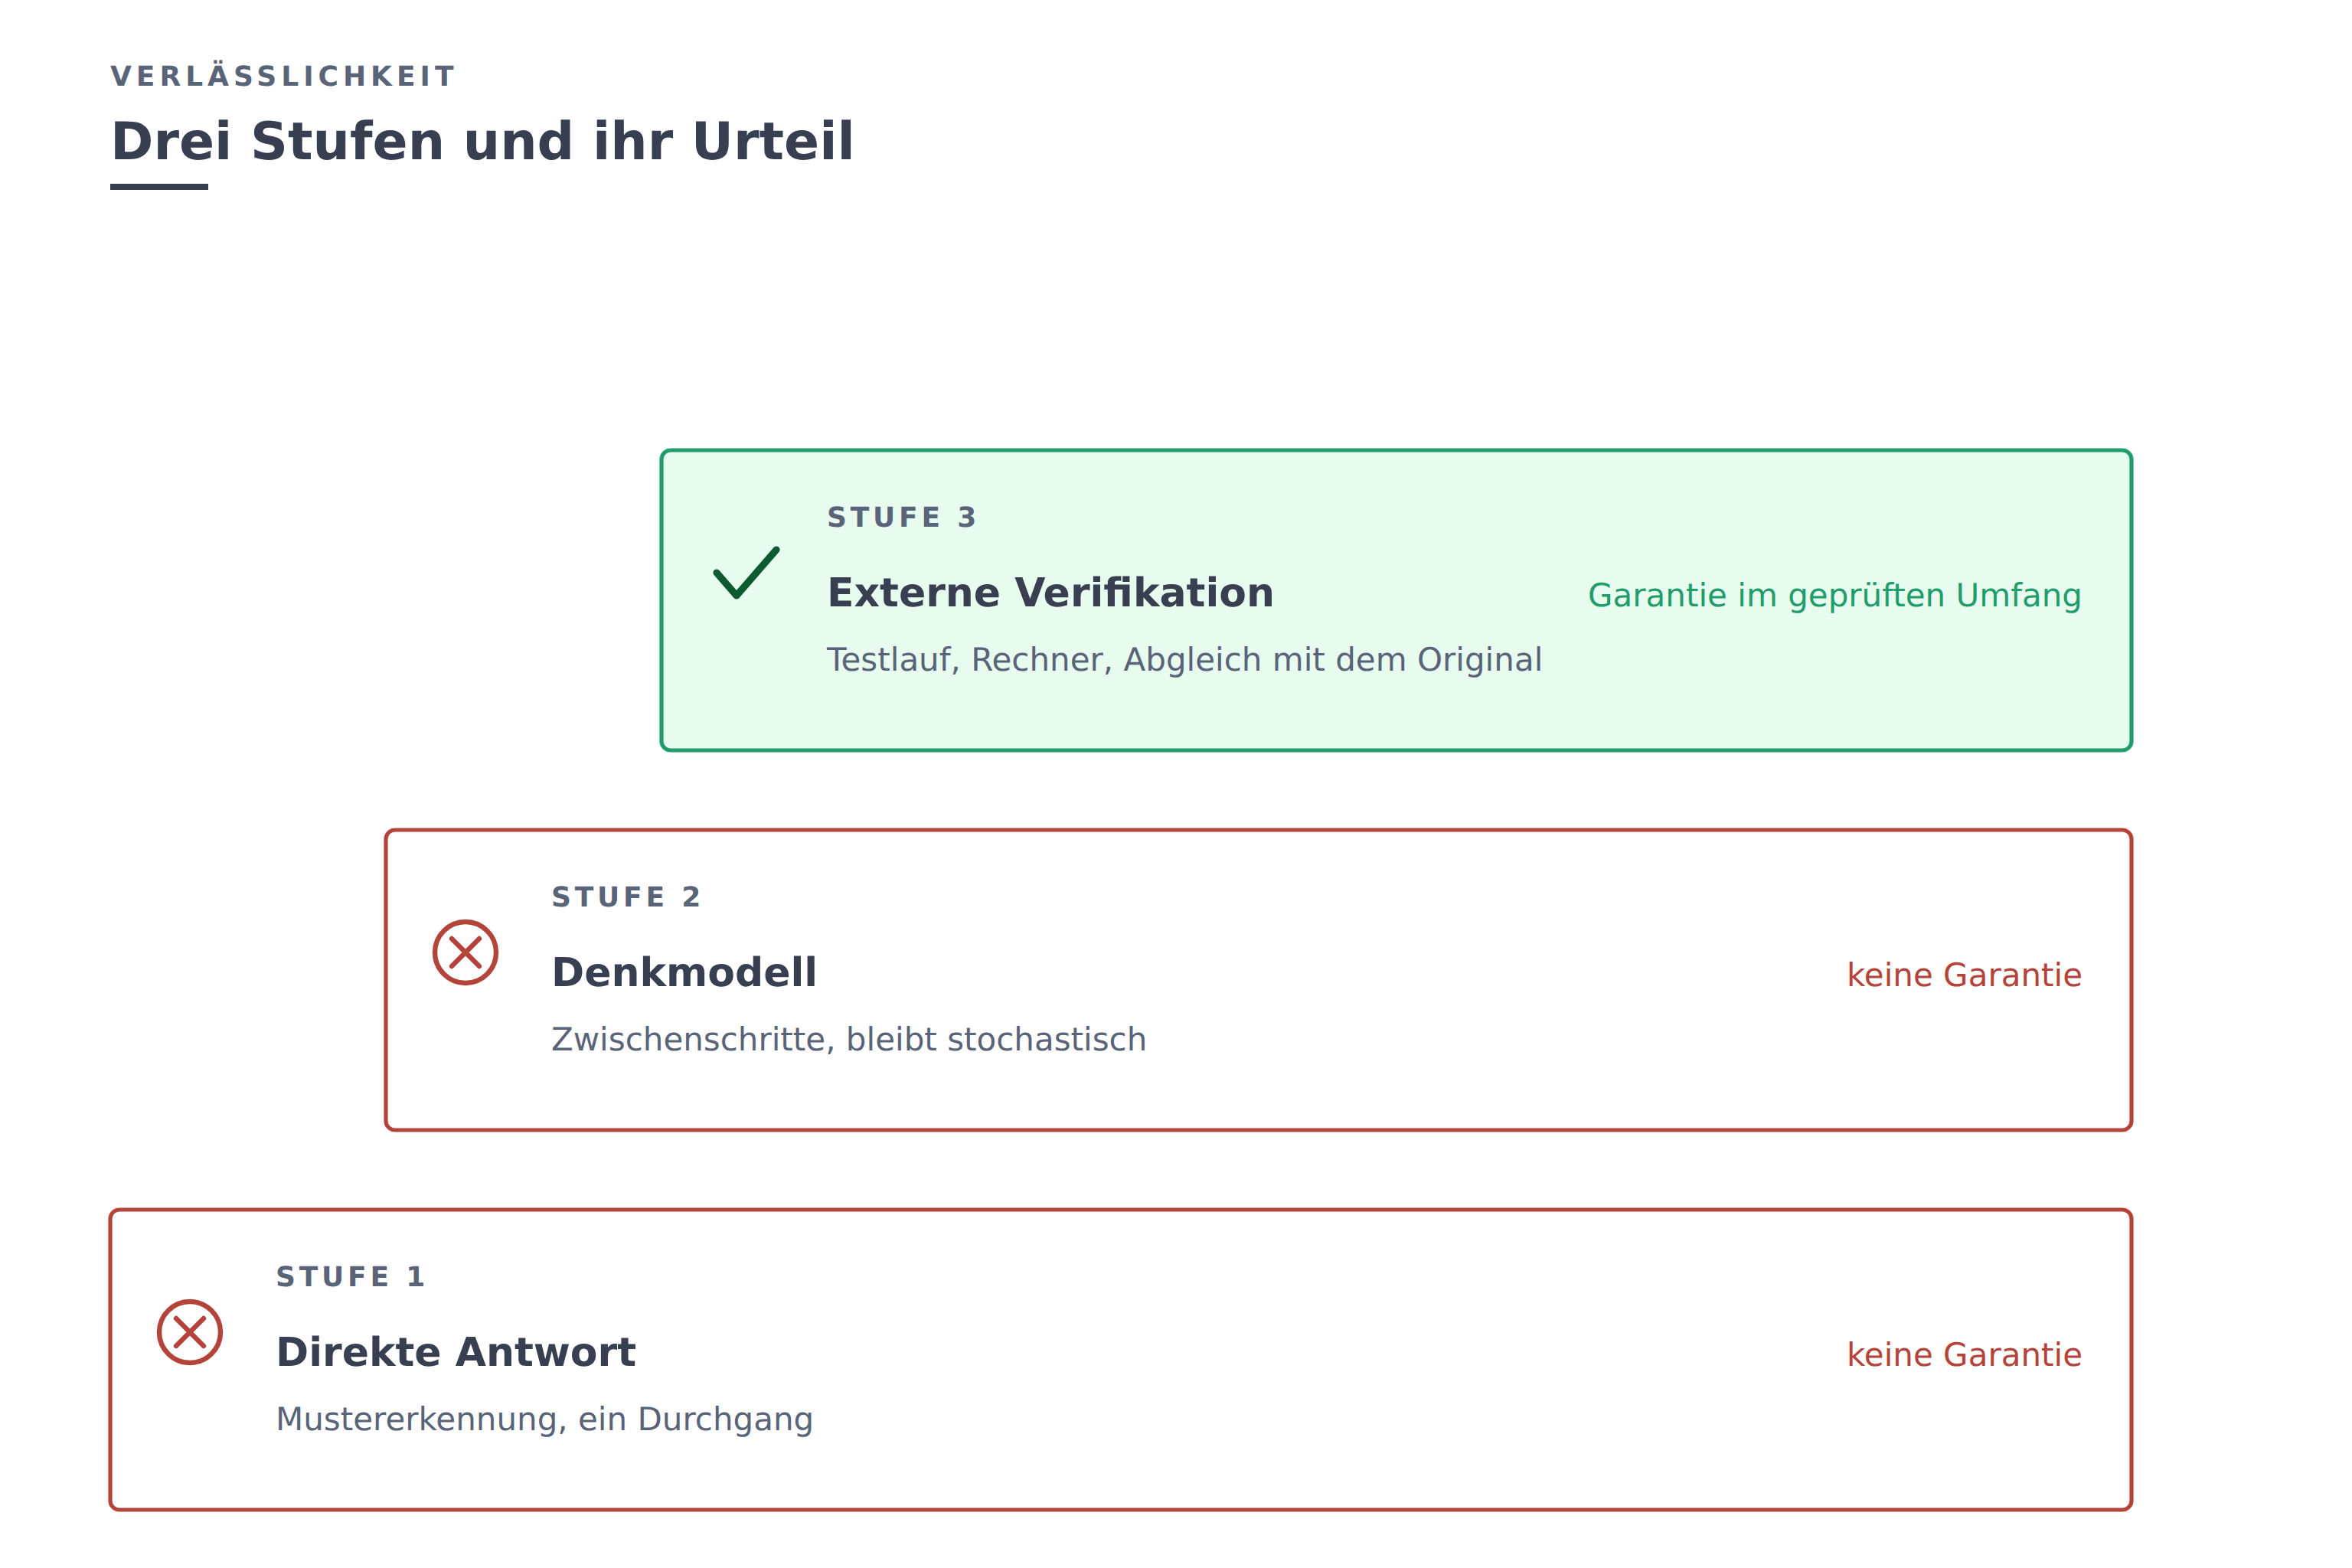
Abbildung 3: Drei Stufen und ihr Urteil.
Abbildung 3 ordnet die drei Stufen danach, was jede zusichert. Die Prüfung kann an drei Orten sitzen. Am Ausgang: Ein Regelwerk prüft den fertigen Entwurf. In der Schleife: Das Modell schreibt eine Abfrage oder ein kleines Programm und ein Rechenwerk außerhalb des Modells führt es aus. In der Datenbasis: Die Fakten stehen gar nicht erst im Modell.
4. Wissensgraphen und neuro-symbolische Systeme verschieben die Prüfung, sie ersetzen sie nicht
Der dritte Ort verdient ein eigenes Kapitel. Auf ihm baut eine ganze Werkzeugklasse auf. Ein Wissensgraph speichert Fakten als Netz aus Knoten und Kanten. Ulm ist der Geburtsort von Einstein. Paracetamol lindert Kopfschmerzen. Eine Abfrage auf diesem Netz läuft ab und dasselbe gilt für eine Regel-Engine mit ihren Wenn-dann-Regeln. Es gilt auch für einen Solver, der die Erfüllbarkeit eines Bedingungssatzes beweist. Der Sammelbegriff lautet neuro-symbolische KI. Das Sprachmodell übernimmt die Sprache. Der symbolische Teil übernimmt die Fakten und die Regeln.
Der Reiz liegt auf der Hand. Das Modell antwortet nicht mehr aus dem Gedächtnis, sondern liest aus einem gepflegten Bestand ab. Beziehungen über mehrere Ecken löst es dort auf, woran eine reine Textsuche scheitert. Der Bestand wird an Ort und Stelle berichtigt, ohne neues Training. Eine Regel-Engine oder ein Solver nimmt in so einem System eine von zwei Rollen ein. Sie steht hinter dem Entwurf als Schranke. Das Modell schlägt einen Rabatt über der internen Obergrenze vor und die Regel-Engine weist ihn zurück. Oder sie steht in der Schleife als Rechenwerk. Das Modell zieht die Kennwerte heraus und der Solver rechnet das Ergebnis aus. Anschließend gießt das Modell diesen Wert in einen Satz. Beide Rollen haben in diesem Text längst einen Namen. Es sind .
Genau diesen Punkt überspringt die Werbung gern. Die Architektur verschiebt die Prüfung und schafft sie nicht ab. Drei Nähte bleiben stochastisch. Erstens muss der Graph befüllt werden. Die Befüllung aus Dokumenten erledigt wieder ein Sprachmodell. Ein falscher Wert wandert so in den Bestand und kommt von dort mit dem Etikett "geprüft" zurück. Zweitens muss die Nutzerfrage in die Abfragesprache übersetzt werden. Auf dem BIRD erzeugte das beste Modell für rund 55 % der gestellten Fragen eine korrekt ausgeführte Abfrage [8]. Eine falsch übersetzte Abfrage läuft danach ohne Fehlermeldung durch. Sie liefert das falsche Ergebnis mit dem Anschein von Gewissheit. Drittens beweist ein Solver nur innerhalb des ihm übergebenen Modells.
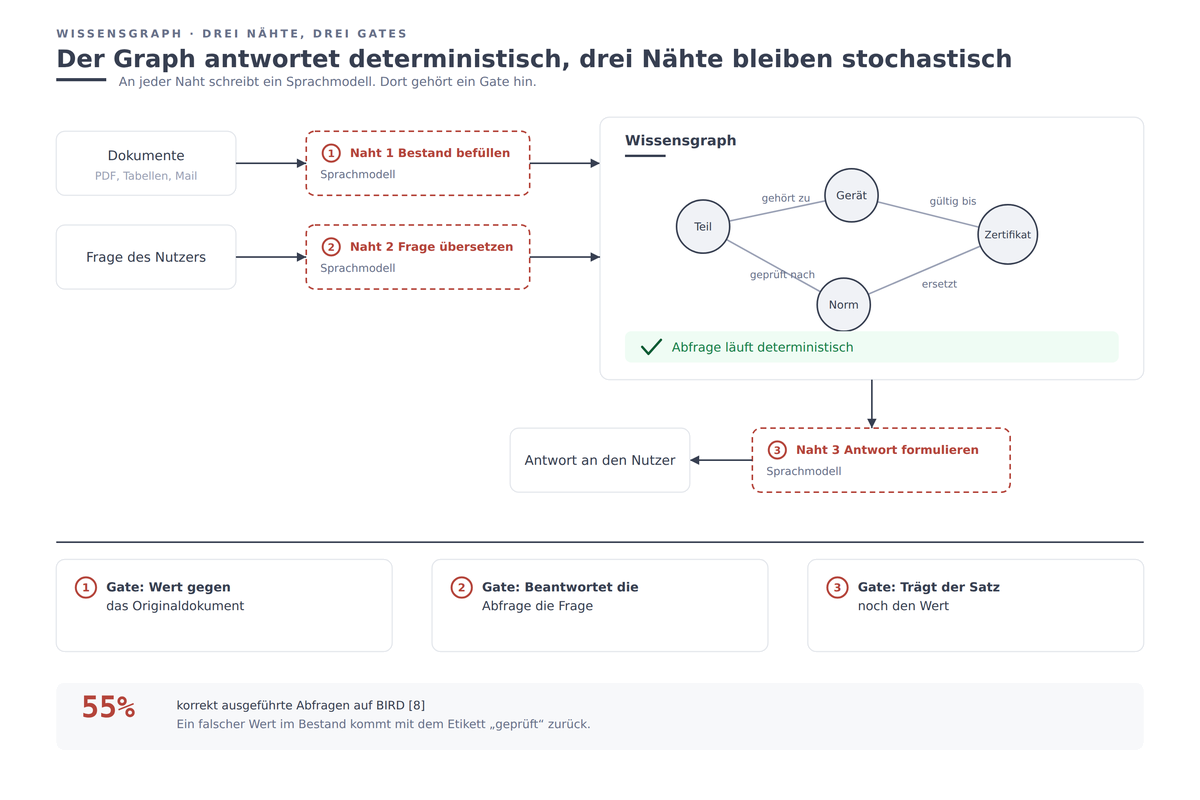
Abbildung 4: Drei Nähte, drei Gates. Der Graph selbst ist nicht das Problem.
Tabelle 2: Wo ein Sprachmodell weiter schreibt und was das Gate dort prüfen muss.
| Naht | Was das Modell tut | Was das Gate prüft |
|---|---|---|
| Bestand befüllen | zieht Fakten aus Dokumenten | den Wert gegen das Originaldokument |
| Frage übersetzen | schreibt die Datenbank-Abfrage | beantwortet die Abfrage die gestellte Frage |
| Antwort formulieren | gießt das Ergebnis in einen Satz | trägt der Satz noch den gelieferten Wert |
Abbildung 4 zeigt die drei Nähte im Ablauf. Die ehrliche Formel lautet deshalb nicht Sprachmodell plus Graphdatenbank. Sie lautet Sprachmodell plus Graphdatenbank plus Gates. Ein Gate je Naht.
Für Code steht die dritte Stufe seit Jahrzehnten bereit: Übersetzer, Testläufe, statische Analyse. Für Dokumente, Recherchen und Datenanalysen fehlt sie meist. Die Folgerung ist in beiden Welten gleich. Der Denkprozess hebt die Wahrscheinlichkeit. Das Gate liefert das Urteil.
Der Denkprozess hebt die Wahrscheinlichkeit. Das Gate liefert das Urteil.
5. Was am Montagmorgen zu tun ist
Drei Fragen entscheiden über den Aufbau und keine davon betrifft das Modell.
Wann lohnt ein Denkmodell? Setzen Sie es bei mehrstufigen Aufgaben ein: ein Entwurf, eine Herleitung, eine Planung, ein Codegerüst. Dort zahlen sich die sichtbaren Zwischenschritte aus. Ein Leser erkennt die Stelle des Abzweigs. Greifen Sie nicht dazu beim einfachen Nachschlagen von Fakten. Auf dem Personenfragen-Test des Herstellers halluzinierte das neuere Denkmodell in 33 % der Fälle gegen 16 % beim Vorgänger [5]. Mehr Denken erzeugt mehr Behauptungen und mit den richtigen wachsen die falschen mit.
Wann lohnt ein Wissensgraph? Sehen Sie sich Ihre Fragen an. Laufen sie über mehrere verknüpfte Fakten, dann trägt ein Graph: welches Teil zu welchem Gerät passt, unter welcher Norm, mit welchem noch gültigen Zertifikat. Besteht Ihre Arbeit aus der Prüfung einzelner Dokumente, ist ein Graph der falsche Aufwand. Dann ist der Abgleich gegen das Originaldokument die billigere Kontrolle, Wert für Wert.
Achten Sie dabei auf einen Unterschied. Ein Notizwerkzeug mit Verlinkungen zwischen Seiten ist kein Wissensgraph. Beim Wiederfinden ist es trotzdem nützlich. Ein Wissensgraph hat benannte Kanten, eine Abfragesprache und eine deterministische Antwort. Verlinkte Notizen geben Ihnen einen Menschen, der schneller liest. Sie geben Ihnen keine Prüfung, die Nein sagt.
Welches kleinste Gate hilft heute? Suchen Sie die im Fehlerfall schmerzhaften Werte heraus: die drei Zahlen, die Frist, die Kündigungsklausel. Diese schlagen Sie selbst im Original nach oder lassen sie von einem Werkzeug vergleichen. Den Rest darf das Modell zusammenfassen. Die Trennlinie verläuft nicht entlang Ihres Vertrauens in das Modell. Sie verläuft entlang der Frage, unter welchen Satz Sie Ihren Namen setzen.
Das ist die ganze Methode. Das Modell entwirft. Eine Prüfung außerhalb des Modells entscheidet. Und die Prüfung sitzt auf den entscheidungstragenden Werten.
6. Quellen
[1] J. Huang u. a., "Large Language Models Cannot Self-Correct Reasoning Yet", ICLR 2024, arXiv:2310.01798.
[2] K. Stechly, M. Marquez und S. Kambhampati, "GPT-4 Doesn't Know It's Wrong", NeurIPS 2023 Workshop, arXiv:2310.12397.
[3] S. Kambhampati u. a., "Position: Can't Plan, But Can Help Planning in LLM-Modulo ", ICML 2024, arXiv:2402.01817.
[4] "Learning to Reason with LLMs", Hersteller-Ankündigung, 2024. https://openai.com/index/learning-to-reason-with-llms/
[5] "o3 and o4-mini System Card", Hersteller-Systemkarte, April 2025. https://cdn.openai.com/pdf/2221c875-02dc-4789-800b-e7758f3722c1/o3-and-o4-mini-system-card.pdf
[6] A. Ng, "Agentic Design Patterns", The Batch, März 2024. https://www.deeplearning.ai/the-batch/how-agents-can-improve-llm-performance
[7] Y. Chen u. a., "Reasoning Models Don't Always Say What They Think", arXiv:2505.05410, 2025.
[8] J. Li u. a., "Can LLM Already Serve as A Database Interface?", NeurIPS 2023, arXiv:2305.03111.