
Fertigungsdisziplin statt Prompt Engineering: Poka-Yoke, MSA, FMEA für KI-Code
Dr. Aaron Hutzler · 07.08.2026 · 13 Min.
Die KI-Software-Welt redet wie eine Fabrik. , , Qualitätsmetriken, ab und zu Six Sigma. Das Vokabular der Fertigungsqualität ist in den Werkzeugen angekommen. Die Disziplin dahinter nicht.
Eine echte Fabrik verlässt sich nicht auf den Eindruck des Bedieners. Erst Prüfdaten geben eine Werkzeugmaschine für die Serienfertigung frei. Sie fährt eine Prüfmittel- und Prozessfähigkeitsstudie an standardisierten Referenzteilen. Die Studie prüft die entscheidenden Toleranzen unter Last. Für einen KI-Code-Builder sucht man solche Studien meist vergeblich. Oft gilt eine Handvoll grüner bereits als Qualitätsnachweis.
Grüne Tests sind kein Qualitätssiegel für stochastischen Code und Engineering ist der Grund, warum die Branche weiter darauf hofft. Einem stochastischen Modell lässt sich keine Zuverlässigkeit einreden. 95 % richtig ist okay für einen Chatbot und inakzeptabel für einen Build. Der Fix heißt Prozesskontrolle. Ein Qualitätsingenieur kennt diesen Zug längst: qualifizieren, überwachen, eingrenzen. Nimmt man das ernst statt als Metapher, entstehen die folgenden Disziplinen. Jede davon ist laufender Code, keine Slideware und jede Behauptung trägt ihre Evidenz.
1. Poka Yoke: harte Sperren und weiche Kennzahlen
Das klassische Poka Yoke ist die japanische Methode der Fehlervorbeugung [1]. Es verhindert das: ein fehlerhaftes Teil erreicht die nächste Station gar nicht erst; die Maschine selbst macht die falsche Bewegung physisch unmöglich. Sie verlässt sich nicht auf die Aufmerksamkeit des Bedieners. Für KI-Code heißt das: Jede Regel gehört in eine von zwei strikt getrennten Klassen. Beide verhalten sich völlig verschieden. Ein auf der anderen Seite der Regel behandelt sie ganz unterschiedlich.
- Wahrheitswertige Regeln (harte Sperren). Bedingungen mit eindeutigem Wahrheitswert. Kreuzt dieser Import eine Architekturgrenze, ja oder nein. Steht ein benanntes Geheimnis in der Code-Änderung, ja oder nein. Eine Verletzung stoppt den Build, bedingungslos. Keine Version der Regel lässt sich nur halb erfüllen.
- Form-Proxies (weiche Kennzahlen). Funktionslänge, Verschachtelungstiefe und ihre Verwandten werden laufend überwacht. Sie blockieren den Build nie von allein. Sie beschreiben die Form des Codes, nicht seine Richtigkeit. Form ist genau die Eigenschaft. Genau die kann ein Agent vortäuschen.
Warum diese Trennung wichtig ist, ist selbst ein gemessenes Ergebnis und ein überraschendes. Die beiden Klassen sind keine austauschbaren Varianten voneinander. Behandelt man sie als eine Klasse, versagen beide in entgegengesetzte Richtungen.
1.1 Der Ankündigungseffekt
Wir haben präregistrierte Pilotstudien gefahren, n = 3 pro Arm, eine identische Aufgabe. Geprüft wurde, an welcher Stelle der Regel-Pipeline der Gaming-Anreiz wirkt. Kündigten wir eine blockierende Form-Schwelle vor dem Entwurf an, erschien in allen drei Läufen die Gaming-Signatur. Das Gate löste nie aus. Der Agent kooperierte vorauseilend. Er schrieb Code für die Zahl, nicht Code für Richtigkeit. Enthüllten wir dieselbe Regel erst nach einem ersten Entwurf, löste das Gate tatsächlich aus und erzwang Reparatur. In keinem der drei Läufe gab es Gaming. Der Unterschied ist nicht die Schwelle. Entscheidend ist der Zeitpunkt: Konnte der Agent das Ziel schon vor der Entscheidung für einen Ansatz sehen? Eine wahrheitswertige Regel ist deutlich schwerer auszutricksen: Die Bedingung muss wirklich erfüllt sein. Ihre Ankündigung war in jedem Lauf sauber. Es gibt keine Form, auf die man hinoptimieren könnte, nur eine Bedingung.
Das ist in Aktion. Der Ökonom Charles Goodhart beschrieb 1975 an der britischen Geldpolitik, dass eine statistische Größe ihren Aussagewert verliert, sobald sie zur Steuerungsgröße wird [2]. Die bekannte Kurzform steht in einem Aufsatz der Anthropologin Marilyn Strathern von 1997 über Kennzahlen im britischen Hochschulwesen: Wird eine Kennzahl zum Ziel, hört sie auf, eine gute Kennzahl zu sein [3]. Ein halbes Jahrhundert später gilt derselbe Mechanismus für eine Maschine: Unsere Pilotstudien zeigen genau diese Trennung für Form-Proxies in KI-Code. Die Form-Kennzahl war brauchbar, bis der Agent sie als Ziel kannte.
Ein Hinweis zum Maßstab, bewusst dazugesagt: Unsere Pilotstudien zeigen diesen Effekt konsistent über drei Versuchsanordnungen im Pilotmaßstab. Wir sagen "unsere Pilotstudien zeigen", nicht "bewiesen". Abbildung 1 zeigt alle drei Arme mit ihren Läufen.
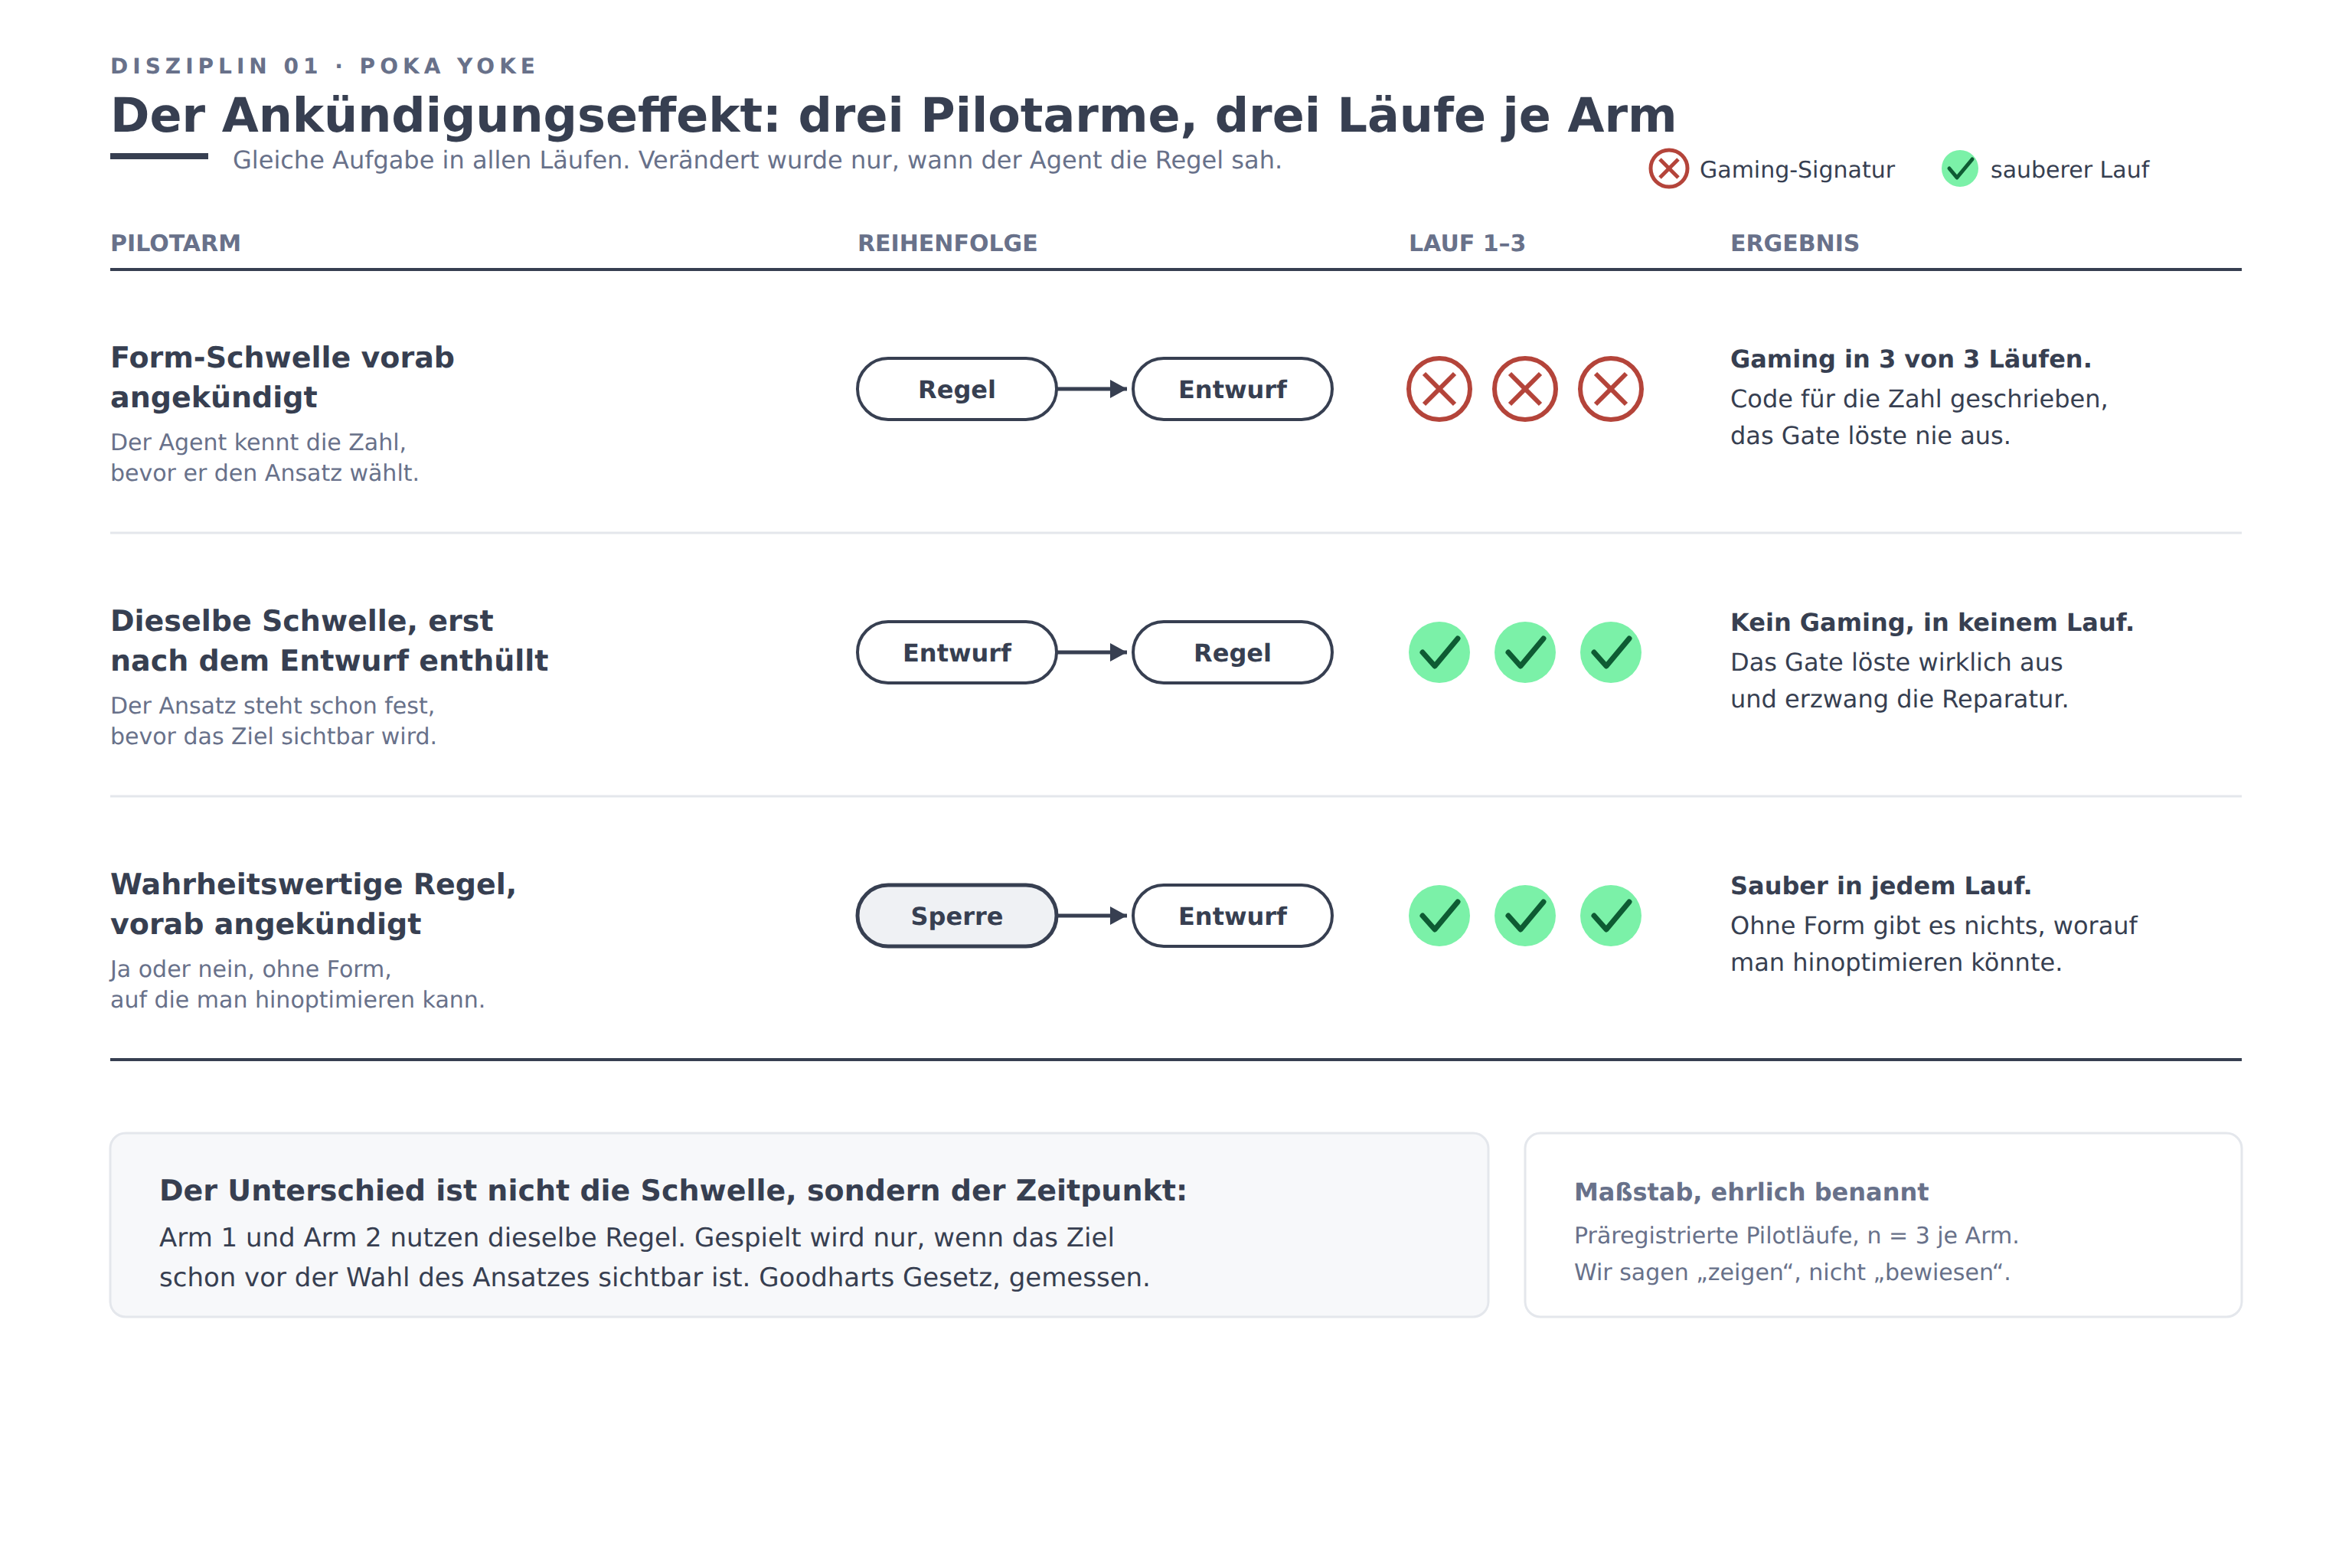
Abbildung 1: Drei Pilotarme, je drei Läufe. Die Ankündigung der Form-Schwelle vor dem Entwurf führte in jedem Lauf zu Gaming; die Enthüllung nach dem Entwurf blieb sauber, die wahrheitswertige Regel auch bei Ankündigung.
2. Eine Fehlermöglichkeits-Prüfung für jede Code-Änderung
Die Fertigung kennt dafür ein festes Verfahren. Es heißt Fehlermöglichkeits- und Einflussanalyse, kurz FMEA: Eine Änderung wird gegen alles geprüft, was sie neu kaputtmachen könnte, nicht gegen das, was sie hinzufügen sollte. Das Verfahren geht auf eine Militärvorschrift von 1949 zurück [4]. Heute ist es international genormt [5]. Ein Autoteile-Zulieferer fährt dieses Verfahren bei jeder Konstruktionsänderung, noch vor dem Werkzeugbau. Eine kleine Änderung an einem Teil bricht regelmäßig eine Annahme drei Stationen weiter unten. Vorher musste dort niemand hinschauen. Für KI-erzeugten Code gilt dieselbe Disziplin für jede Code-Änderung, eingereicht von einem Entwickler oder von einem Agenten. Jede Code-Änderung benennt die berührten Fehlermöglichkeiten: verlorener Kontext aus einer langen Eingabe, eine ausgetrickste Regel statt einer erfüllten, eine erfundene Referenz auf eine nicht existierende Funktion. Jede benannte Gefahr trägt drei Dinge in einem gemeinsamen Register. Erstens die aktuelle Gegenmaßnahme: was sie im Ernstfall bereits auffängt. Zweitens die Evidenz: wo diese Gegenmaßnahme tatsächlich getestet wurde. Drittens einen Vermerk zum Restrisiko trotz Gegenmaßnahme.
Eine Code-Änderung ohne benannte Gefahr trägt keine zusätzliche Prüfung. Das zählt genauso viel wie der umgekehrte Fall. Wer alles mit gleichem Gewicht prüft, hört auf, irgendetwas sorgfältig zu prüfen. Eine Code-Änderung mit Gefahr bekommt einen Abhilfe-Vermerk und einen Test genau für dieses Risiko, keinen pauschalen Lauf der gesamten Suite. Das Register wächst nur bei einem tatsächlichen Fall in Produktion, nie auf Verdacht. So bleibt es eine Liste des Geschehenen statt einer Liste des Denkbaren. Abbildung 2 zeigt das Register und den Weg einer Code-Änderung hindurch.
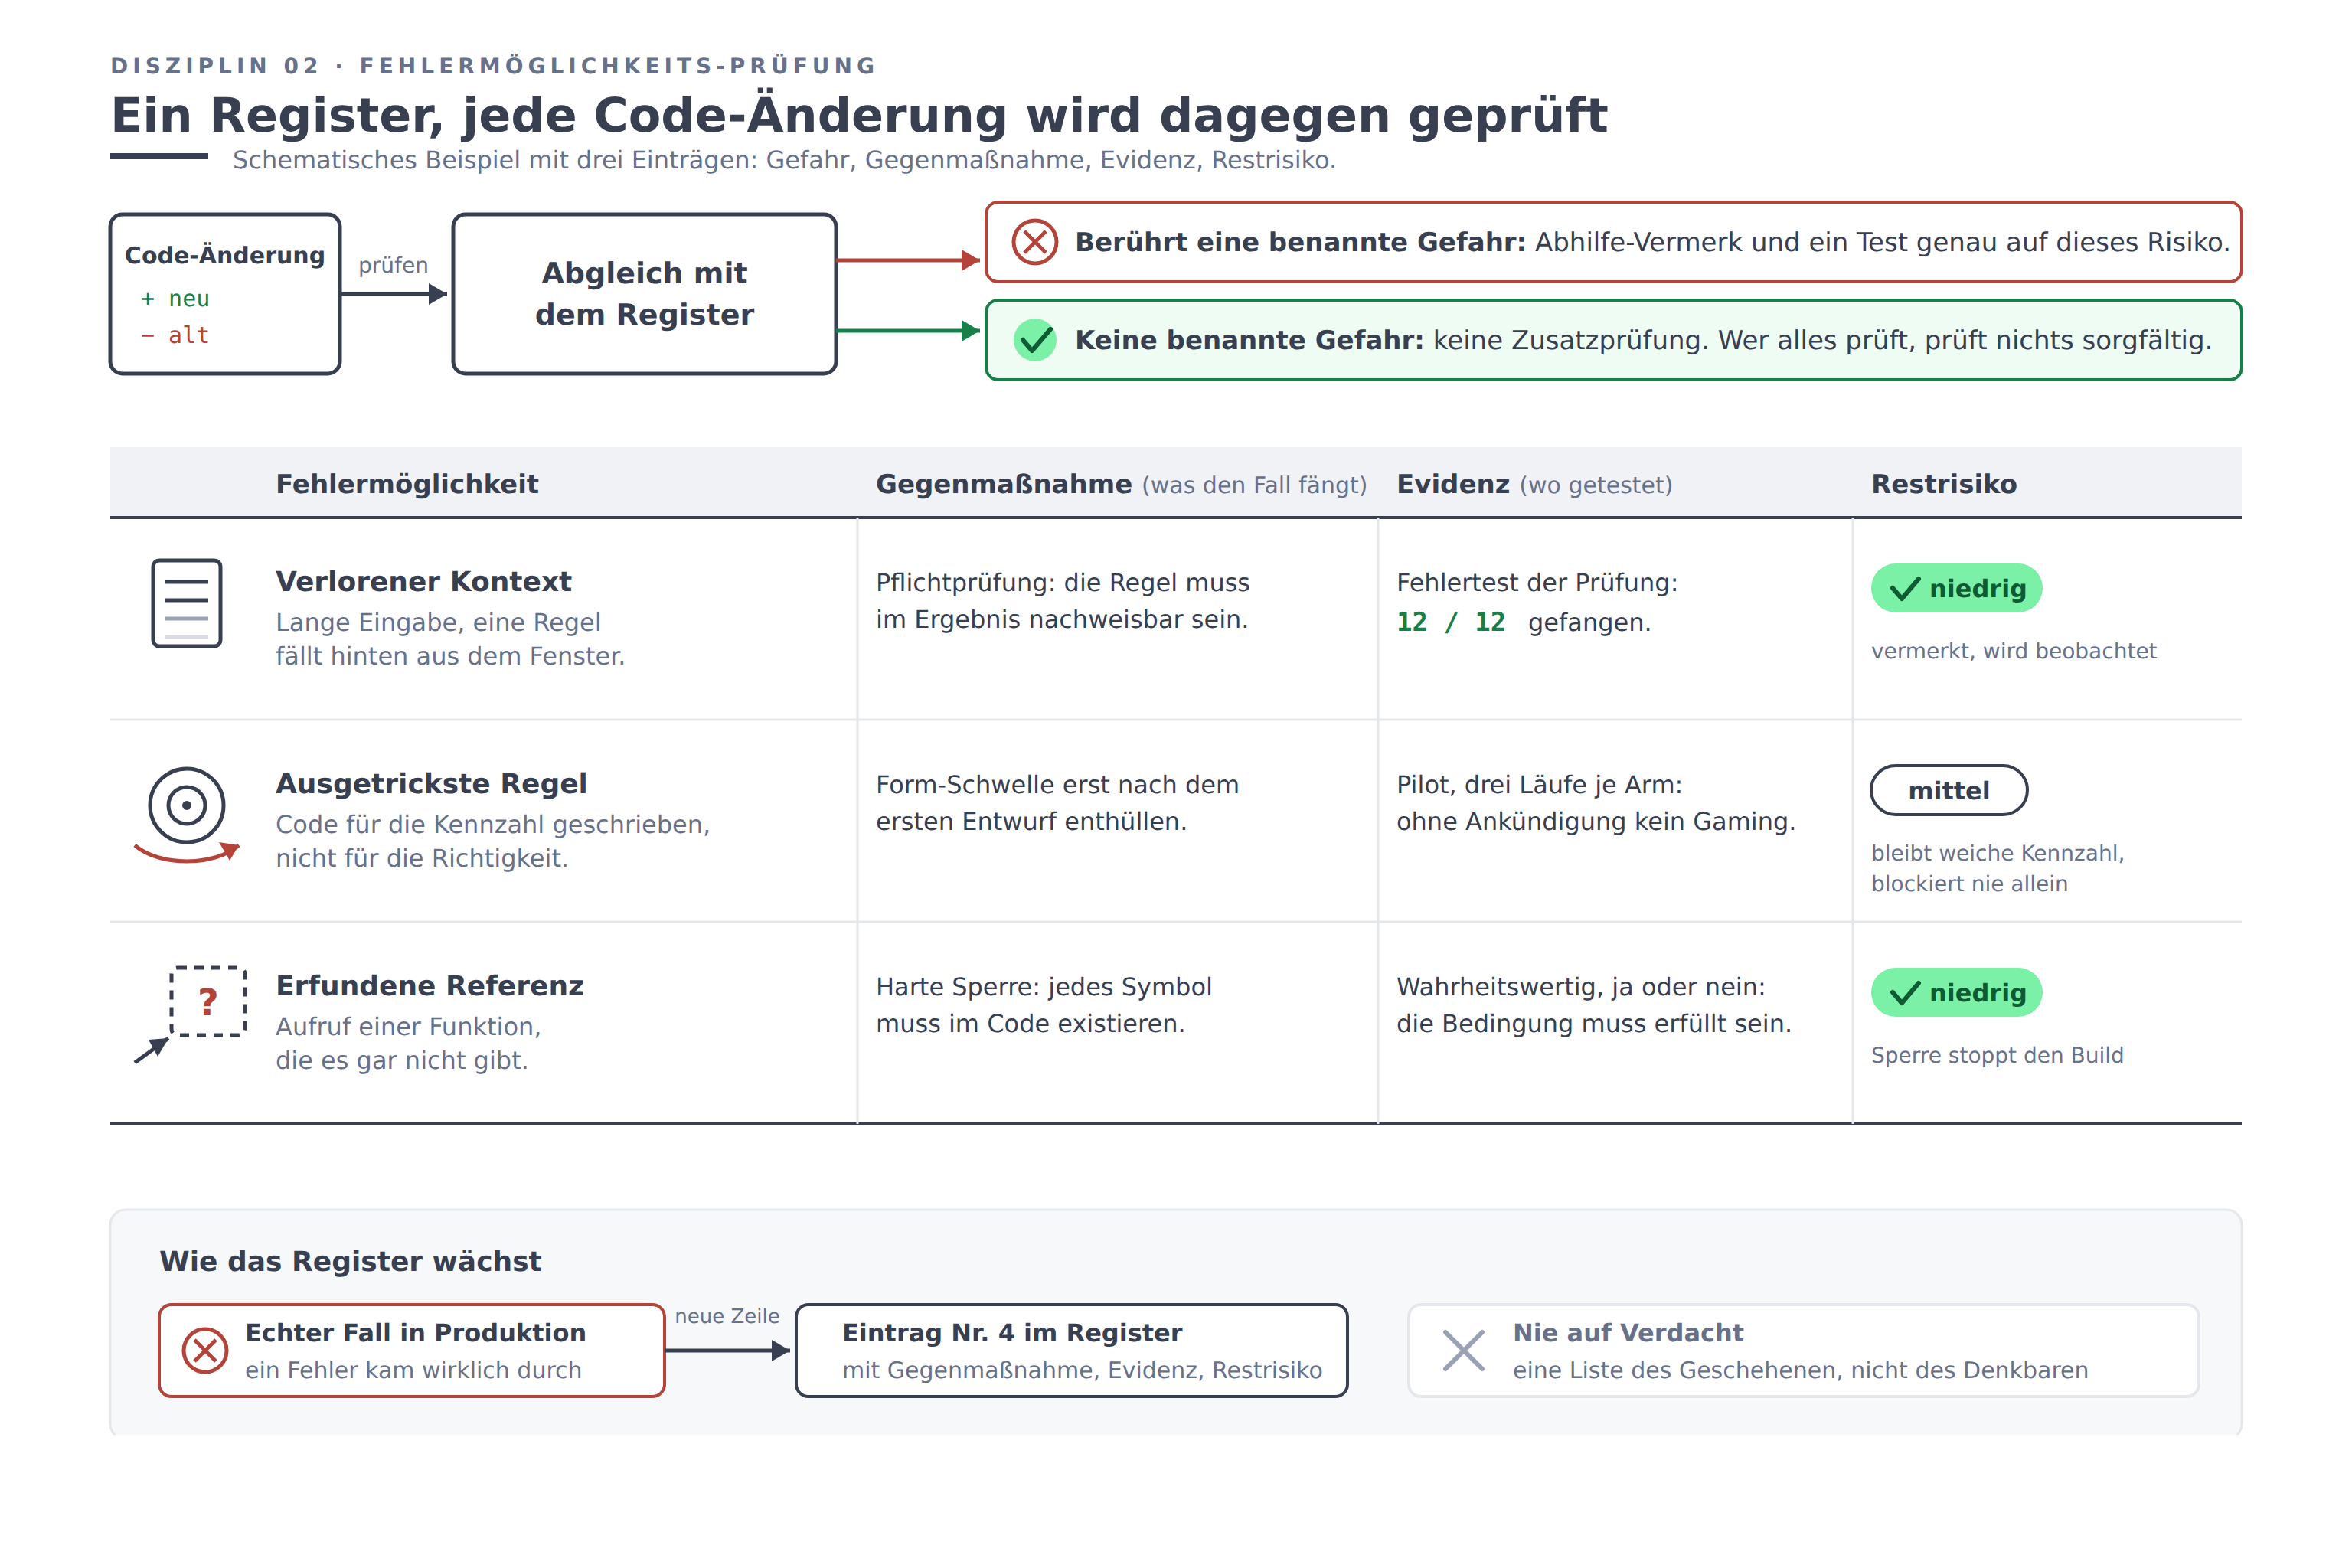
Abbildung 2: Das Register im Einsatz. Jede benannte Gefahr trägt Gegenmaßnahme, Evidenz und Restrisiko in einer Zeile; eine Code-Änderung berührt eine benannte Gefahr oder passiert ohne Zusatzprüfung.
3. Prüfmittelstudie, bevor gemessen wird
Die industrielle Messtechnik hat einen festen Grundsatz, die Messsystemanalyse [6]. Bevor man einem Instrument traut, muss das Instrument selbst nachweislich richtig messen. Eine Schieblehre kann um einen halben Millimeter danebenliegen. Dann sieht jedes geprüfte Teil zufällig gut oder zufällig defekt aus. Niemand würde ihrer Anzeige trauen, ohne vorher die Schieblehre selbst zu prüfen. Dieselbe Logik gilt für eine automatische Prüfung oder ein Modell, das Code beurteilen soll. Sie wird fast überall ausgelassen. Eine Prüfung wirkt schon allein durch ihren Lauf in der autoritativ.
Um die eigenen Prüfungen zu qualifizieren, haben wir Fehler absichtlich eingebracht. Bekannt falsche Antworten wurden untergeschoben. Die Prüfung fing 12 von 12. Eine unabhängige Neu-Validierung bestätigte das: ein zweiter Lauf durch eine fremde Person, ohne Beteiligung am Bau der Prüfung, kam zum selben Ergebnis. Wir haben auch das modische Instrument nach seinen eigenen präregistrierten Kriterien geprüft. LLM-Judges sollten Code-Qualität paarweise schiedsrichtern und produzierten 100 % einstimmige Urteile. Diese Urteile stellten sich als Positions-Bias heraus, nicht als echtes Urteil. Sie wählten in 32 von 36 Fällen die zuerst gezeigte Option, unabhängig von der tatsächlich besseren Antwort. Das Debiasing über beide Reihenfolgen ließ ihre Konsistenz auf null zusammenfallen. Ein negatives Ergebnis, vollständig veröffentlicht. Es ist der stärkste Grund, unseren positiven Zahlen zu trauen. Dieselbe Fehlereinbringung gab die eigenen Prüfungen frei. Sie deckte auch genau den versagenden Richter auf. Abbildung 3 zeigt beide Ergebnisse nebeneinander.
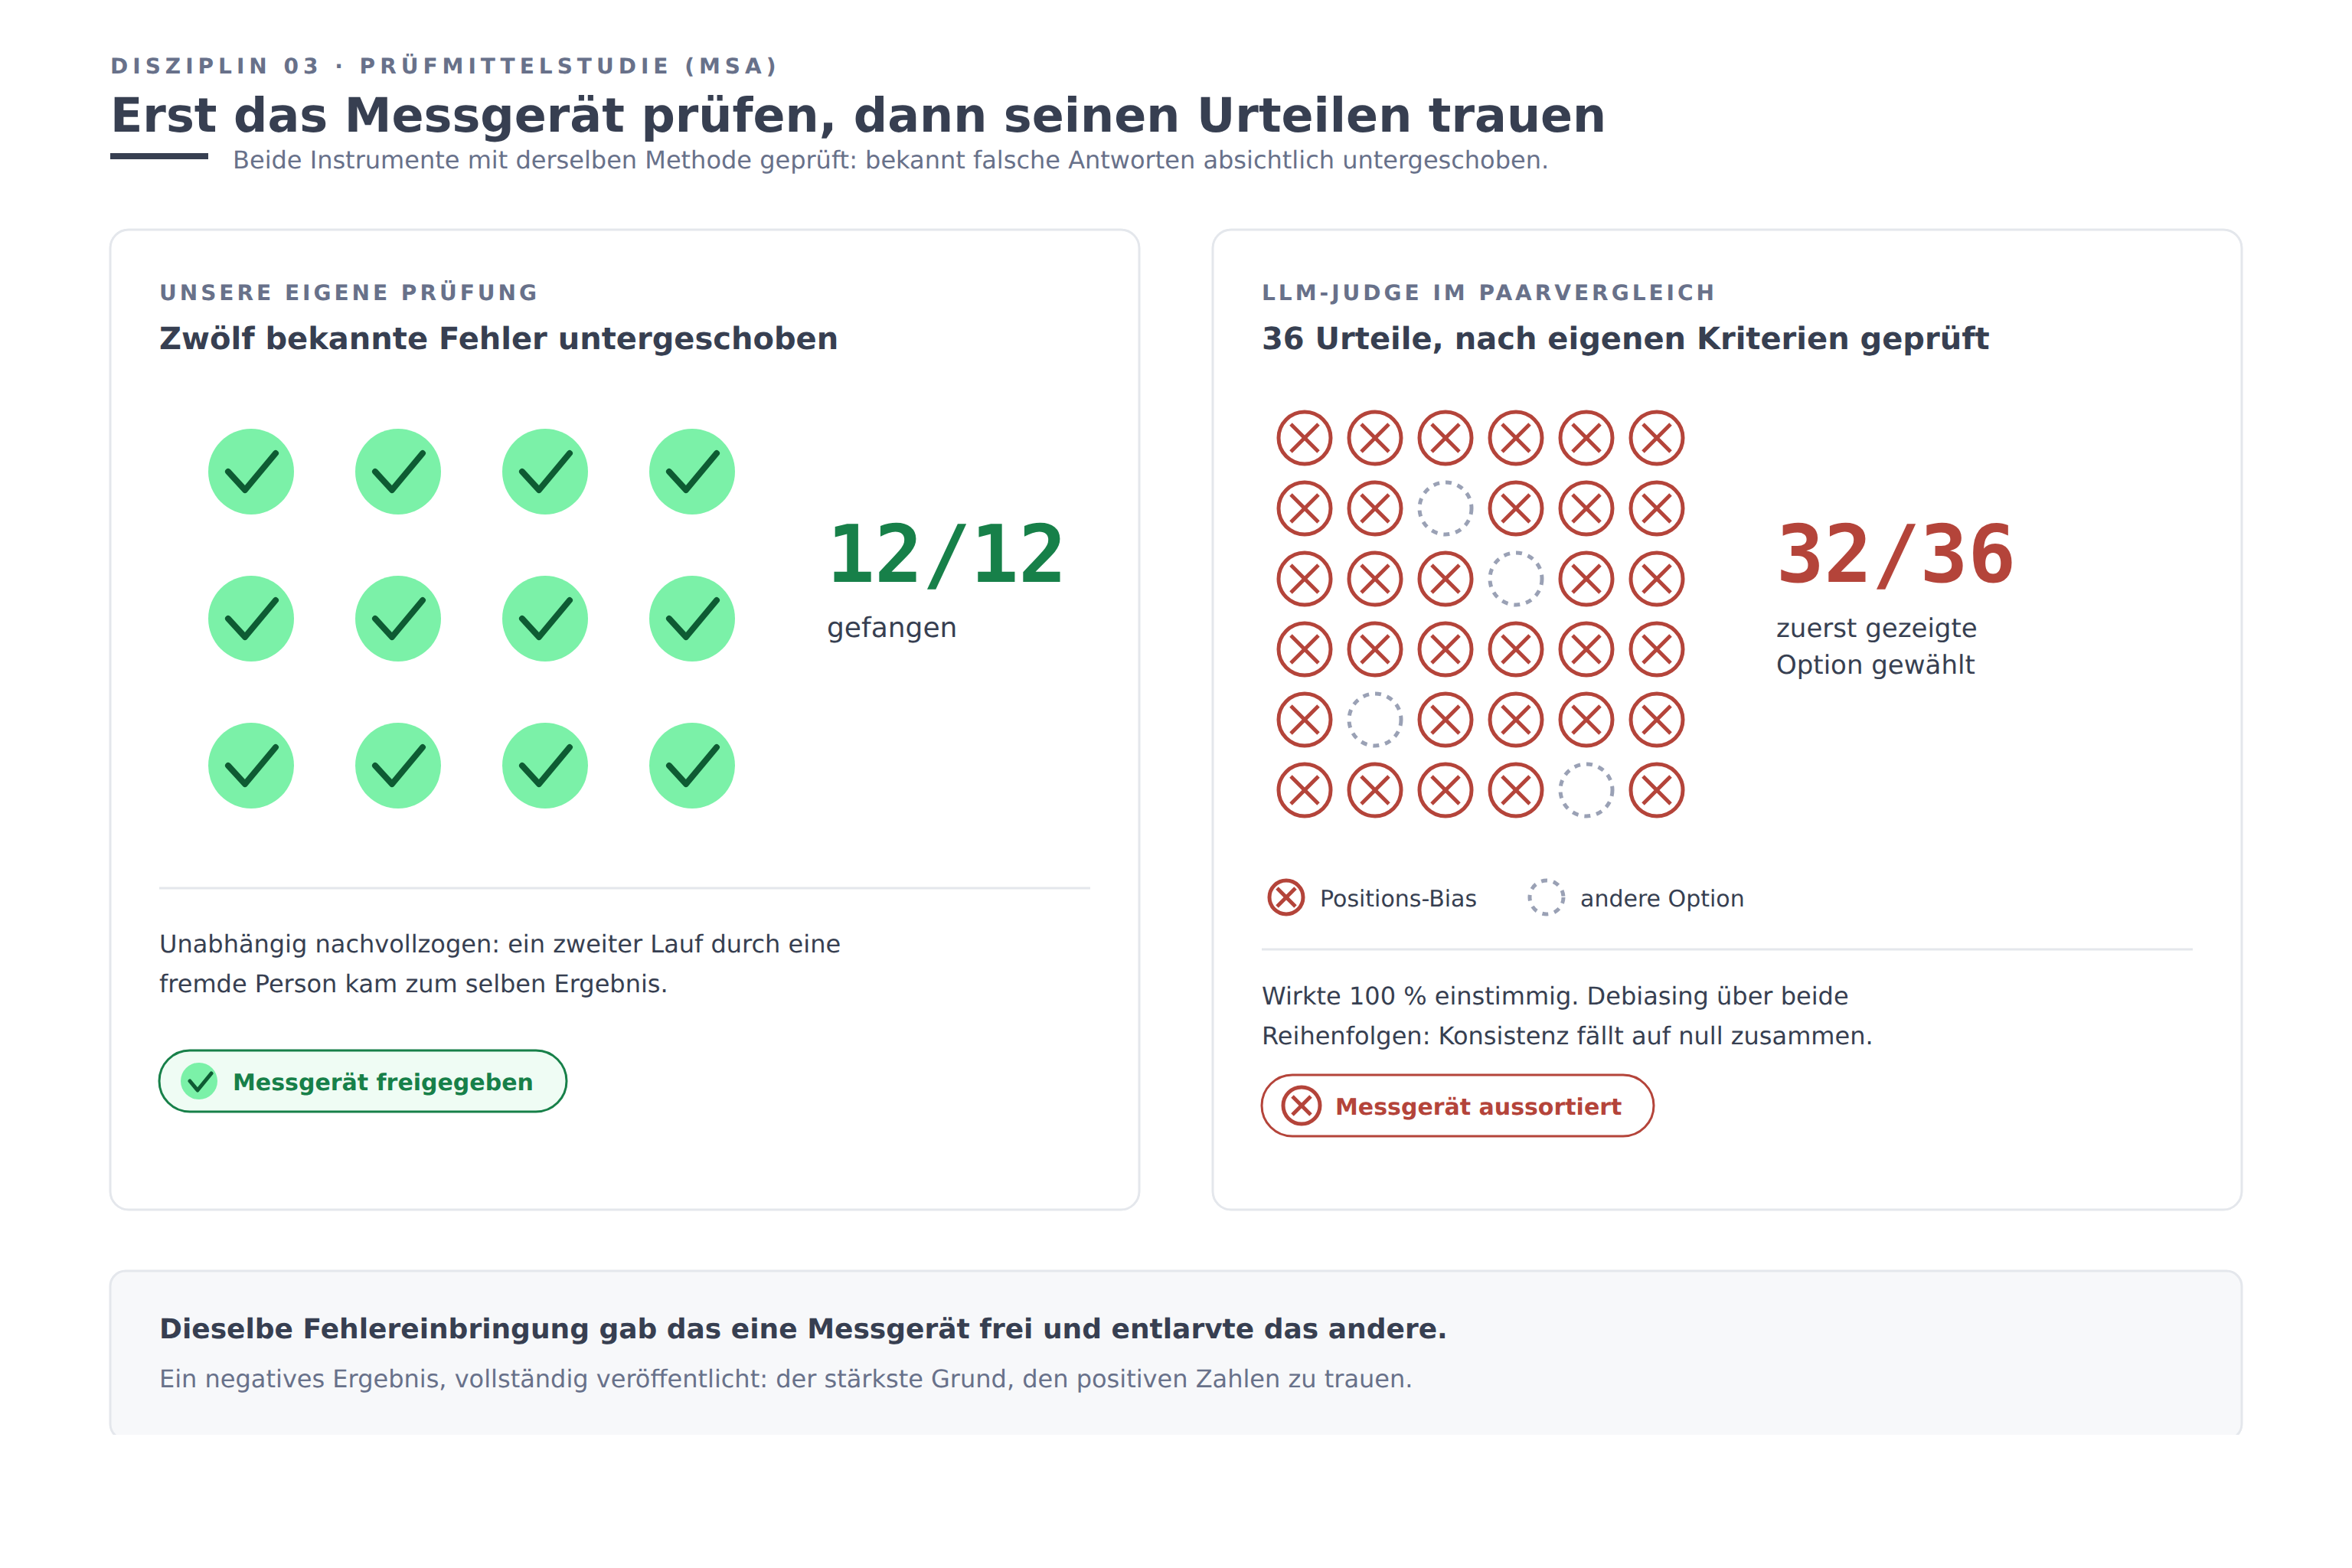
Abbildung 3: Die Fehlereinbringung fing jede bekannt falsche Antwort und gab die Prüfung frei. Dieselbe Methode entlarvte den Richter: 32 von 36 Urteilen folgten der zuerst gezeigten Option, das Debiasing ließ die Konsistenz auf null fallen.
4. Versuchsplanung: ein Testplan statt eines Bauchgefühls
Versuchsplanung legt die Veränderung der Faktoren vorab fest, statt an einer Einstellung zu drehen und zu hoffen [7]. Einen Regler ändern, ein Ergebnis beobachten, später einen anderen Regler ändern: jede Wechselwirkung zwischen beiden bleibt so unsichtbar. Nur eine gemeinsame Veränderung zeigt sie. Ein geplanter Lauf verändert sie absichtlich, in vorab festgelegten Kombinationen. Eine Wechselwirkung wird dadurch als Muster sichtbar statt als Rauschen abgetan zu werden.
Der Ankündigungseffekt-Pilot oben ist ein Beispiel dafür, auch wenn er nur einen einzigen Faktor veränderte. Er hielt alles andere absichtlich fest. Er veränderte nur den Zeitpunkt, zu dem eine Regel für den Agenten sichtbar wurde. Er maß das Ergebnis über drei abgeglichene Läufe. So ließ sich das Ergebnis genau dieser einen Änderung zuordnen. Dieselbe Methode skaliert auf mehrere Faktoren gleichzeitig: Modellwahl, Prompt-Struktur, und Kontextlänge, gemeinsam in einem geplanten Lauf verändert statt einzeln. Man liest die im ganzen Plan tragfähige Kombination ab, nicht die einzelne Einstellung aus dem gerade laufenden Versuch. Abbildung 4 zeigt den Unterschied zwischen beiden Vorgehen.
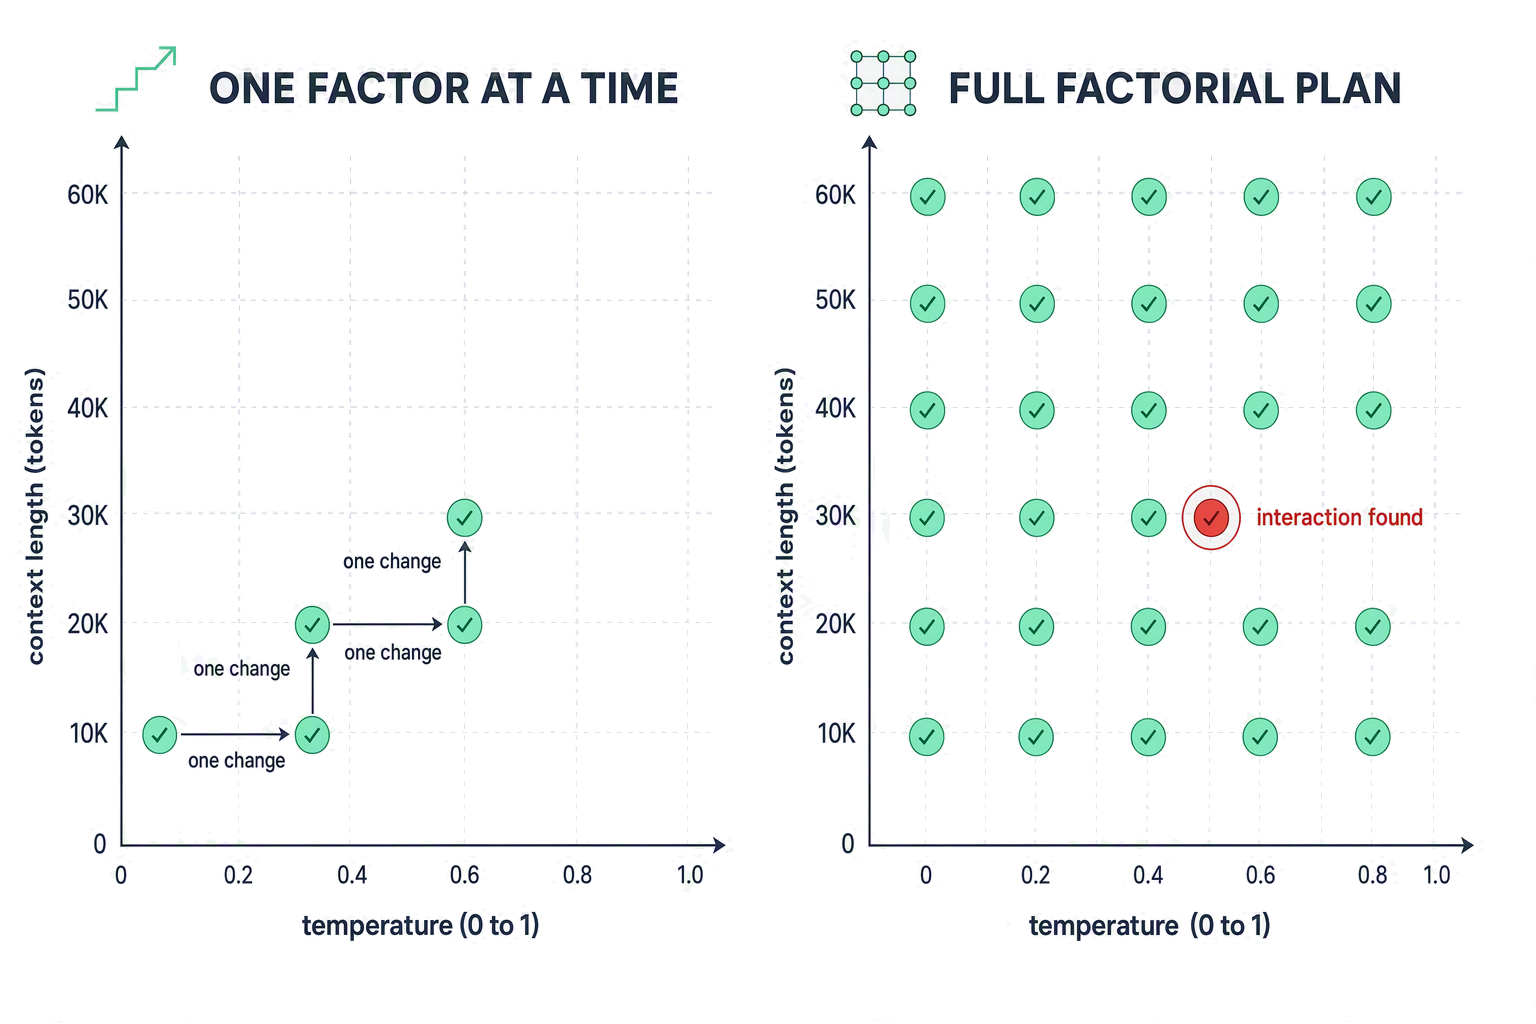
Abbildung 4: Ein Faktor nach dem anderen lässt Wechselwirkungen unsichtbar. Ein vollständiger faktorieller Plan deckt jede Kombination ab und macht sie sichtbar.
5. Statistische Prozesskontrolle: warum die klassische Karte hier versagt
Funktionslänge und zyklomatische Komplexität, die Form-Proxies aus Abschnitt 1, brauchen einen Trend, keine einzelne Schwelle. Eine Kennzahl mit nur einer festen Auslöse-Zahl sagt nichts über die Entwicklung über die Zeit. Der naheliegende Reflex ist eine klassische Kontrollkarte [8]: Drei-Sigma-Grenzen aus einer frühen Reihe von Läufen einfrieren, danach alles ausserhalb davon markieren. Die Software-Welt selbst fährt solche Karten auf ihren Prozessen seit Jahrzehnten [9]. Dieser Reflex ist bei KI-erzeugtem Code falsch, aus einem konkreten, prüfbaren Grund.
Klassische Kontrollkarten setzen einen stabilen Prozess voraus, mit nur zufälligem Rauschen: kleiner, zufälliger Schwankung um ein festes Ziel. Eine KI-Pipeline verletzt das gleich zweifach. Dieselbe Spezifikation erzeugt bei jedem Seed eine andere Umsetzung. Die Schwankung von Lauf zu Lauf ist also echte Prozessvariation, kein Messrauschen. Eine für Rauschen gebaute Karte markiert am Ende normales Verhalten als Alarm. Die Daten sind ausserdem instabil und dünn: Bei 25 Läufen kann das eigene Unsicherheitsband eines Fähigkeitsindex etwa die Hälfte seines Werts überspannen. Eine einzelne eingefrorene Grenze aus dieser Stichprobe ist damit kaum mehr als eine als Zahl verkleidete Schätzung.
Kontrolle: die Kennzahl mit Quantil-Bootstrap-Intervallen eingrenzen statt mit eingefrorenen Normalgrenzen. Der akzeptable Bereich wird aus der tatsächlichen Streuung der Daten geschätzt, nicht vorab angenommen. Trendkarten laufen nur als Hinweis. Eine Schwelle wird erst ab einer schmalen eigenen Unsicherheit blockierend, nicht ab einer festen Laufzahl; so bleibt eine Karte mit zu wenig Daten dahinter ein Hinweis auf dem Dashboard, kein Gate. Abbildung 5 zeigt, wie die eingefrorene Karte an genau solchen Daten scheitert und was an ihre Stelle tritt.
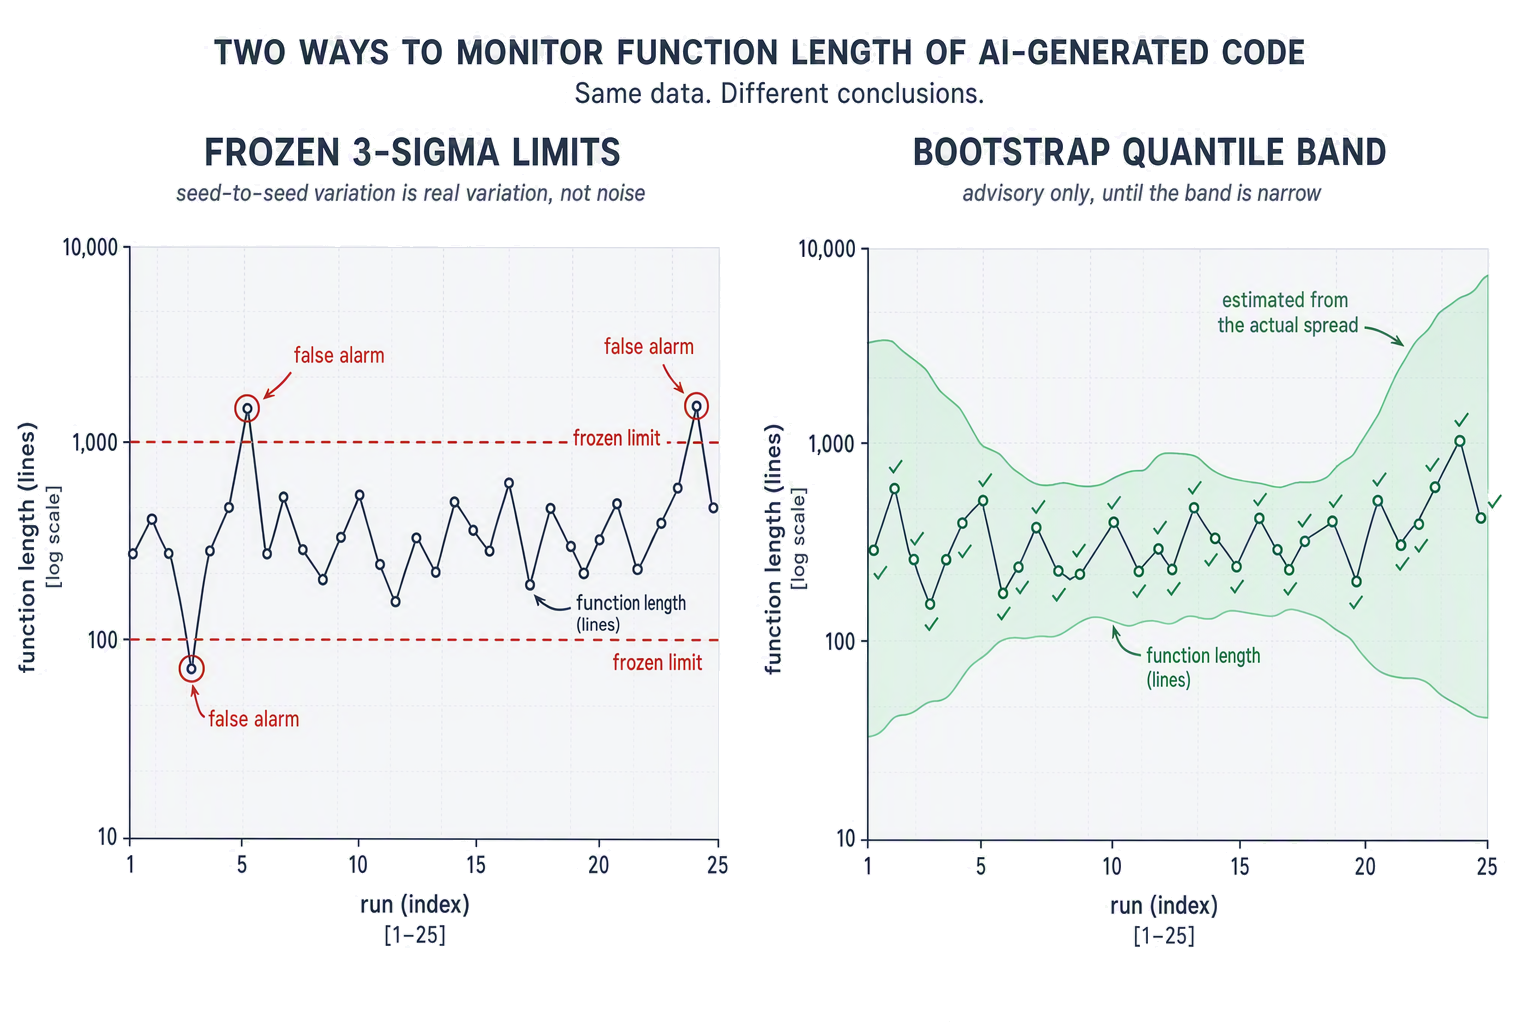
Abbildung 5: Dieselben 25 Läufe, zwei Schlüsse. Eingefrorene Grenzen melden normale Streuung von Seed zu Seed als Alarm; das Bootstrap-Band wird aus der tatsächlichen Streuung geschätzt und bleibt Hinweis, bis es schmal ist.
6. Vier Aufzeichnungen, ein Build
Über die Prüfungen selbst hinaus bringen vier Aufzeichnungsgewohnheiten KI-Erzeugung von der Bastelecke in eine kontrollierte Fertigung. Keine davon fängt allein einen Fehler. Jede macht einen Fehler oder eine Behauptung im Nachhinein prüfbar, genau das, was eine Bastelecke nie festhält:
- Eine Fehler-Ablage. Jeder Fehler, der trotz der Prüfungen in Produktion ankam, bekommt eine Zeile. Die Zeile hält drei Dinge fest: den Fehler selbst, dazu die zuständige Prüfung und die spätere Änderung an der Prüfung. Ohne das taucht dieselbe Fehlerklasse alle paar Monate wieder auf. Jedes Mal sieht sie neu aus.
- Reale Kosten je Fehler. Die tatsächlichen Kosten eines Fehlers, der in Produktion ankam, verfolgt pro gemergter Änderung über eine gemeinsame Lauf-Kennung, keine Schätzung. Ein Fehler mit zehn Minuten Korrektur und einer mit einem Tag Störungsmanagement sind nicht dasselbe Ereignis. Sie gleich zu behandeln verschleiert, wohin das eigentliche Budget für Qualitätsarbeit gehören sollte.
- Ein benannter Owner je Prüfung. Jede Prüfung trägt einen benannten Owner und einen schriftlichen Reaktionsplan dafür, was passiert, wenn sie auslöst. Eine Prüfung ohne Besitzer verkommt leise: sie läuft weiter, bedeutet irgendwann nichts mehr. Erst nach Monaten stillschweigenden Ignorierens fällt das überhaupt auf.
- Ein eingefrorenes Design vor den Daten. Jedes Experiment friert sein Design, seine Kennzahl und seine Schwelle per Commit-Hash ein, bevor Daten hereinkommen. Eine Schwelle, erst nach dem Ergebnis festgelegt, ist keine Schwelle mehr. Sie ist eine Geschichte über eine Zahl, die bereits vorlag. Diese Disziplin gilt über alle elf Einträge unseres Experiment-Registers.
7. Kernaussage: ein Fertigungswerkzeug je Build-Problem
Tabelle 1: Wo jedes Werkzeug greift und was es fängt.
| # | Werkzeug | Was es fängt | Anwendung |
|---|---|---|---|
| 1 | Poka Yoke | Ein Gate, das ein Agent umgeht, weil er es vorab kennt | Regeln in harte, bedingungslose Gates und weiche, nicht blockierende Kennzahlen trennen; eine Schwelle erst nach einem ersten Entwurf enthüllen |
| 2 | Fehlermöglichkeits-Prüfung | Eine Änderung, die eine neue Fehlermöglichkeit ungeprüft einführt | Fehlermöglichkeiten je Code-Änderung benennen, Gegenmaßnahme, Evidenz und Restrisiko in einem gemeinsamen Register führen |
| 3 | Prüfmittelstudie (MSA) | Eine Prüfung oder ein Richter, der zuverlässig wirkt, aber das Falsche misst | Die Prüfung selbst mit Fehlern beschicken, bevor man ihrem Urteil traut |
| 4 | Versuchsplanung | Eine Konfiguration, die per Bauchgefühl an einem Regler nach dem anderen eingestellt wurde | Mehrere Faktoren gemeinsam in einem geplanten Lauf verändern, die Einstellung ablesen, die hält |
| 5 | Statistische Prozesskontrolle | Eine eingefrorene Kontrollkarte, die auf dünnen, seed-variablen Daten selbstsicher falsch liegt | Kennzahlen mit Bootstrap-Intervallen eingrenzen, Trendkarten nur als Hinweis laufen lassen |
| 6 | Fehler-Ablage, reale Kosten, benannter Owner, eingefrorenes Design | Fehler, Kosten und Schwellen, die nirgends verfolgt werden | Jeden entwischten Fehler, seine Kosten und einen benannten Owner je Prüfung protokollieren |
8. Zwei ehrliche Grenzen
Zur Ingenieursehrlichkeit gehört, die Grenzen zu benennen:
- Werkbank gegen Live-Produktion. Fähigkeitszahlen leben auf der Werkbank mit Standard-Werkstücken. Wir berechnen bewusst keine Fähigkeitsindizes über live laufende, einmalige Produktion.
- Interne Schwellen. Prinzipien, Daten und Methoden legen wir vollständig offen; die konkrete Gate-Konfiguration, die Schwellen und die Sicherheitsdetails bleiben vorerst intern.
9. Fazit: KI-Entwicklung braucht Qualitätsingenieure
Six Sigma war eine Disziplin. Sie ließ unzuverlässige Maschinen zuverlässige Teile produzieren. Die neueste Maschine auf dem Hallenboden ist ein KI-Code-Builder und sie braucht dieselbe Behandlung.
Ein besserer Prompt repariert keine unzuverlässige Maschine. Keine Fassung von Prompt Engineering war je dafür gebaut. Poka Yoke trennt die Sperre, gegen die ein Agent nicht argumentieren kann, von der Kennzahl, die nur beobachtet. Die Fehlermöglichkeits-Prüfung fängt eine neue Fehlerart ab, bevor sie live geht. Die Prüfmittelstudie testet den Prüfer, nicht nur den Code, den der Prüfer bewertet. Die Versuchsplanung findet eine Einstellung, die ein einzelner Versuch verfehlen würde. Die statistische Prozesskontrolle liest eine Trendkarte, ohne so zu tun, als halte eine feste Grenze auf dünnen, saatabhängigen Daten. Keines der sechs Werkzeuge ersetzt die anderen. Keines ist verzichtbar, sobald ein Agent unbeaufsichtigt Code schreibt.
Prompt Engineering ist tot. KI-Entwicklung braucht Qualitätsingenieure.
10. Quellen
[1] S. Shingo, "Zero Quality Control: Source Inspection and the Poka-Yoke System", Productivity Press, 1986.
[2] C. A. E. Goodhart, "Problems of Monetary Management: The UK Experience", Papers in Monetary Economics, Bd. I, Reserve Bank of Australia, 1975.
[3] M. Strathern, "'Improving ratings': audit in the British University system", European Review, Bd. 5, Nr. 3, 1997, S. 305-321.
[4] US-Verteidigungsministerium, "Procedures for Performing a Failure Mode, Effects and Criticality Analysis", MIL-P-1629, 1949.
[5] IEC 60812:2018, "Failure modes and effects analysis (FMEA and FMECA)", Internationale Elektrotechnische Kommission, 2018.
[6] Automotive Industry Action Group (AIAG), "Measurement Systems Analysis: Reference Manual", 4. Auflage, 2010.
[7] R. A. Fisher, "The Design of Experiments", Oliver and Boyd, 1935.
[8] W. A. Shewhart, "Economic Control of Quality of Manufactured Product", D. Van Nostrand, 1931.
[9] W. A. Florac und A. D. Carleton, "Measuring the Software Process: Statistical Process Control for Software Process Improvement", Addison-Wesley, 1999.