
Der Lauf ist echt: beim Kartenspiel, im Sport und bei der KI
Dr. Aaron Hutzler · 17.08.2026 · 10 Min.
Kartenspieler nennen es einen Lauf. Alles fällt: die richtige Karte, die richtige Lesart, der richtige Moment. Dann kippt es. Zwei Stunden später wirkt jedes Blatt schon beim ersten Aufnehmen unspielbar. Sportler beschreiben denselben Effekt in ihrer Disziplin, Trainer planen ihre Auswechslungen danach. Offen ist die Frage nach dem Lauf selbst: gibt es ihn, oder erzählt ihn das Gehirn im Nachhinein?
Die Forschung antwortet zweiteilig. Erstens verändert ein Lauf die tatsächliche Leistung. Zweitens übertreibt die Wahrnehmung ihn zusätzlich. Beide Teile haben eine Entsprechung in der Maschine. Die Maschinenfassung lässt sich dabei deutlich leichter messen als die menschliche Fassung. Ein Modell verteidigt kein Selbstbild.
1. Die Studie, die 33 Jahre lang falsch war
Gilovich, Vallone und Tversky untersuchten 1985 Würfe von NBA-Spielern [1]. Sie fanden keinen Beleg für die heiße Hand. Ein Treffer nach drei Treffern war nicht wahrscheinlicher als ein Treffer nach drei Fehlwürfen. Das Urteil hielt drei Jahrzehnte. Der Lauf galt als Häufungs-Illusion, als Muster im Rauschen.
Die Korrektur kam 2018 von Miller und Sanjurjo [2]. Die alte Methode enthält einen Auswahlfehler. Man nehme eine endliche Folge von Münzwürfen. Daraus suche man die Würfe nach drei Mal Kopf heraus. Unter genau diesen Würfen steht im Mittel häufiger Zahl als in der Hälfte der Fälle. Der Fehler steckt in der Zählregel. Mit dem Schützen hat er nichts zu tun. Bei realistischen Folgenlängen reicht er aus, um das Ergebnis zu drehen.
Nach der Korrektur kehren sich die alten Daten um. Im Wurfexperiment von Gilovich trafen die Spieler nach drei oder mehr Treffern in Folge etwa 11 Prozentpunkte besser. Dieser Abstand entspricht ungefähr dem Unterschied zwischen einem durchschnittlichen Dreierschützen der NBA und einem der besten der Liga.
2. Warum ein guter Lauf echt ist
Eine trainierte Bewegung läuft ohne bewusste Steuerung ab. Beilock und Carr zeigten 2001 eine erstaunliche Lücke: erfahrene Golfer erinnern die Einzelheiten ihrer eigenen Putts nicht [3]. Das Können ist prozedural gespeichert. Es wird unterhalb der schrittweisen Aufmerksamkeit ausgeführt.
Druck zerstört genau das. Der Spieler überwacht plötzlich eine Bewegung mit vorher selbsttätigem Ablauf. Das Timing geht verloren. Der nächste Fehler erhöht den Druck weiter. So erklärt die Sportpsychologie das Versagen unter Druck und damit auch die Unsymmetrie zwischen gutem und schlechtem Lauf. Zutrauen lässt das schnelle System arbeiten. Zweifel schaltet das langsame darüber.
3. Warum eine Pechsträhne schlimmer wird
Am Kartentisch ist die Verteilung zufällig. Die Entscheidungen sind es nicht. Die Pokerforschung nennt diese Frustspirale Tilt [4]. Gemeint ist ein negativer Gefühlszustand nach harten Niederlagen oder einer langen Verlustserie, gekennzeichnet durch Kontrollverlust und messbar schlechtere Entscheidungen. Auslöser ist ein Gefühl von Ungerechtigkeit. Darauf folgt das Hinterherjagen, der Versuch auf sofortige Rückholung des Geldes.
Eine Stunde lang lagen die Karten schlecht. Die drei Stunden danach lag das Spiel schlecht. Aus einer Pechsträhne wird eine Fehlerserie.
4. Dieselbe Form im Sprachmodell
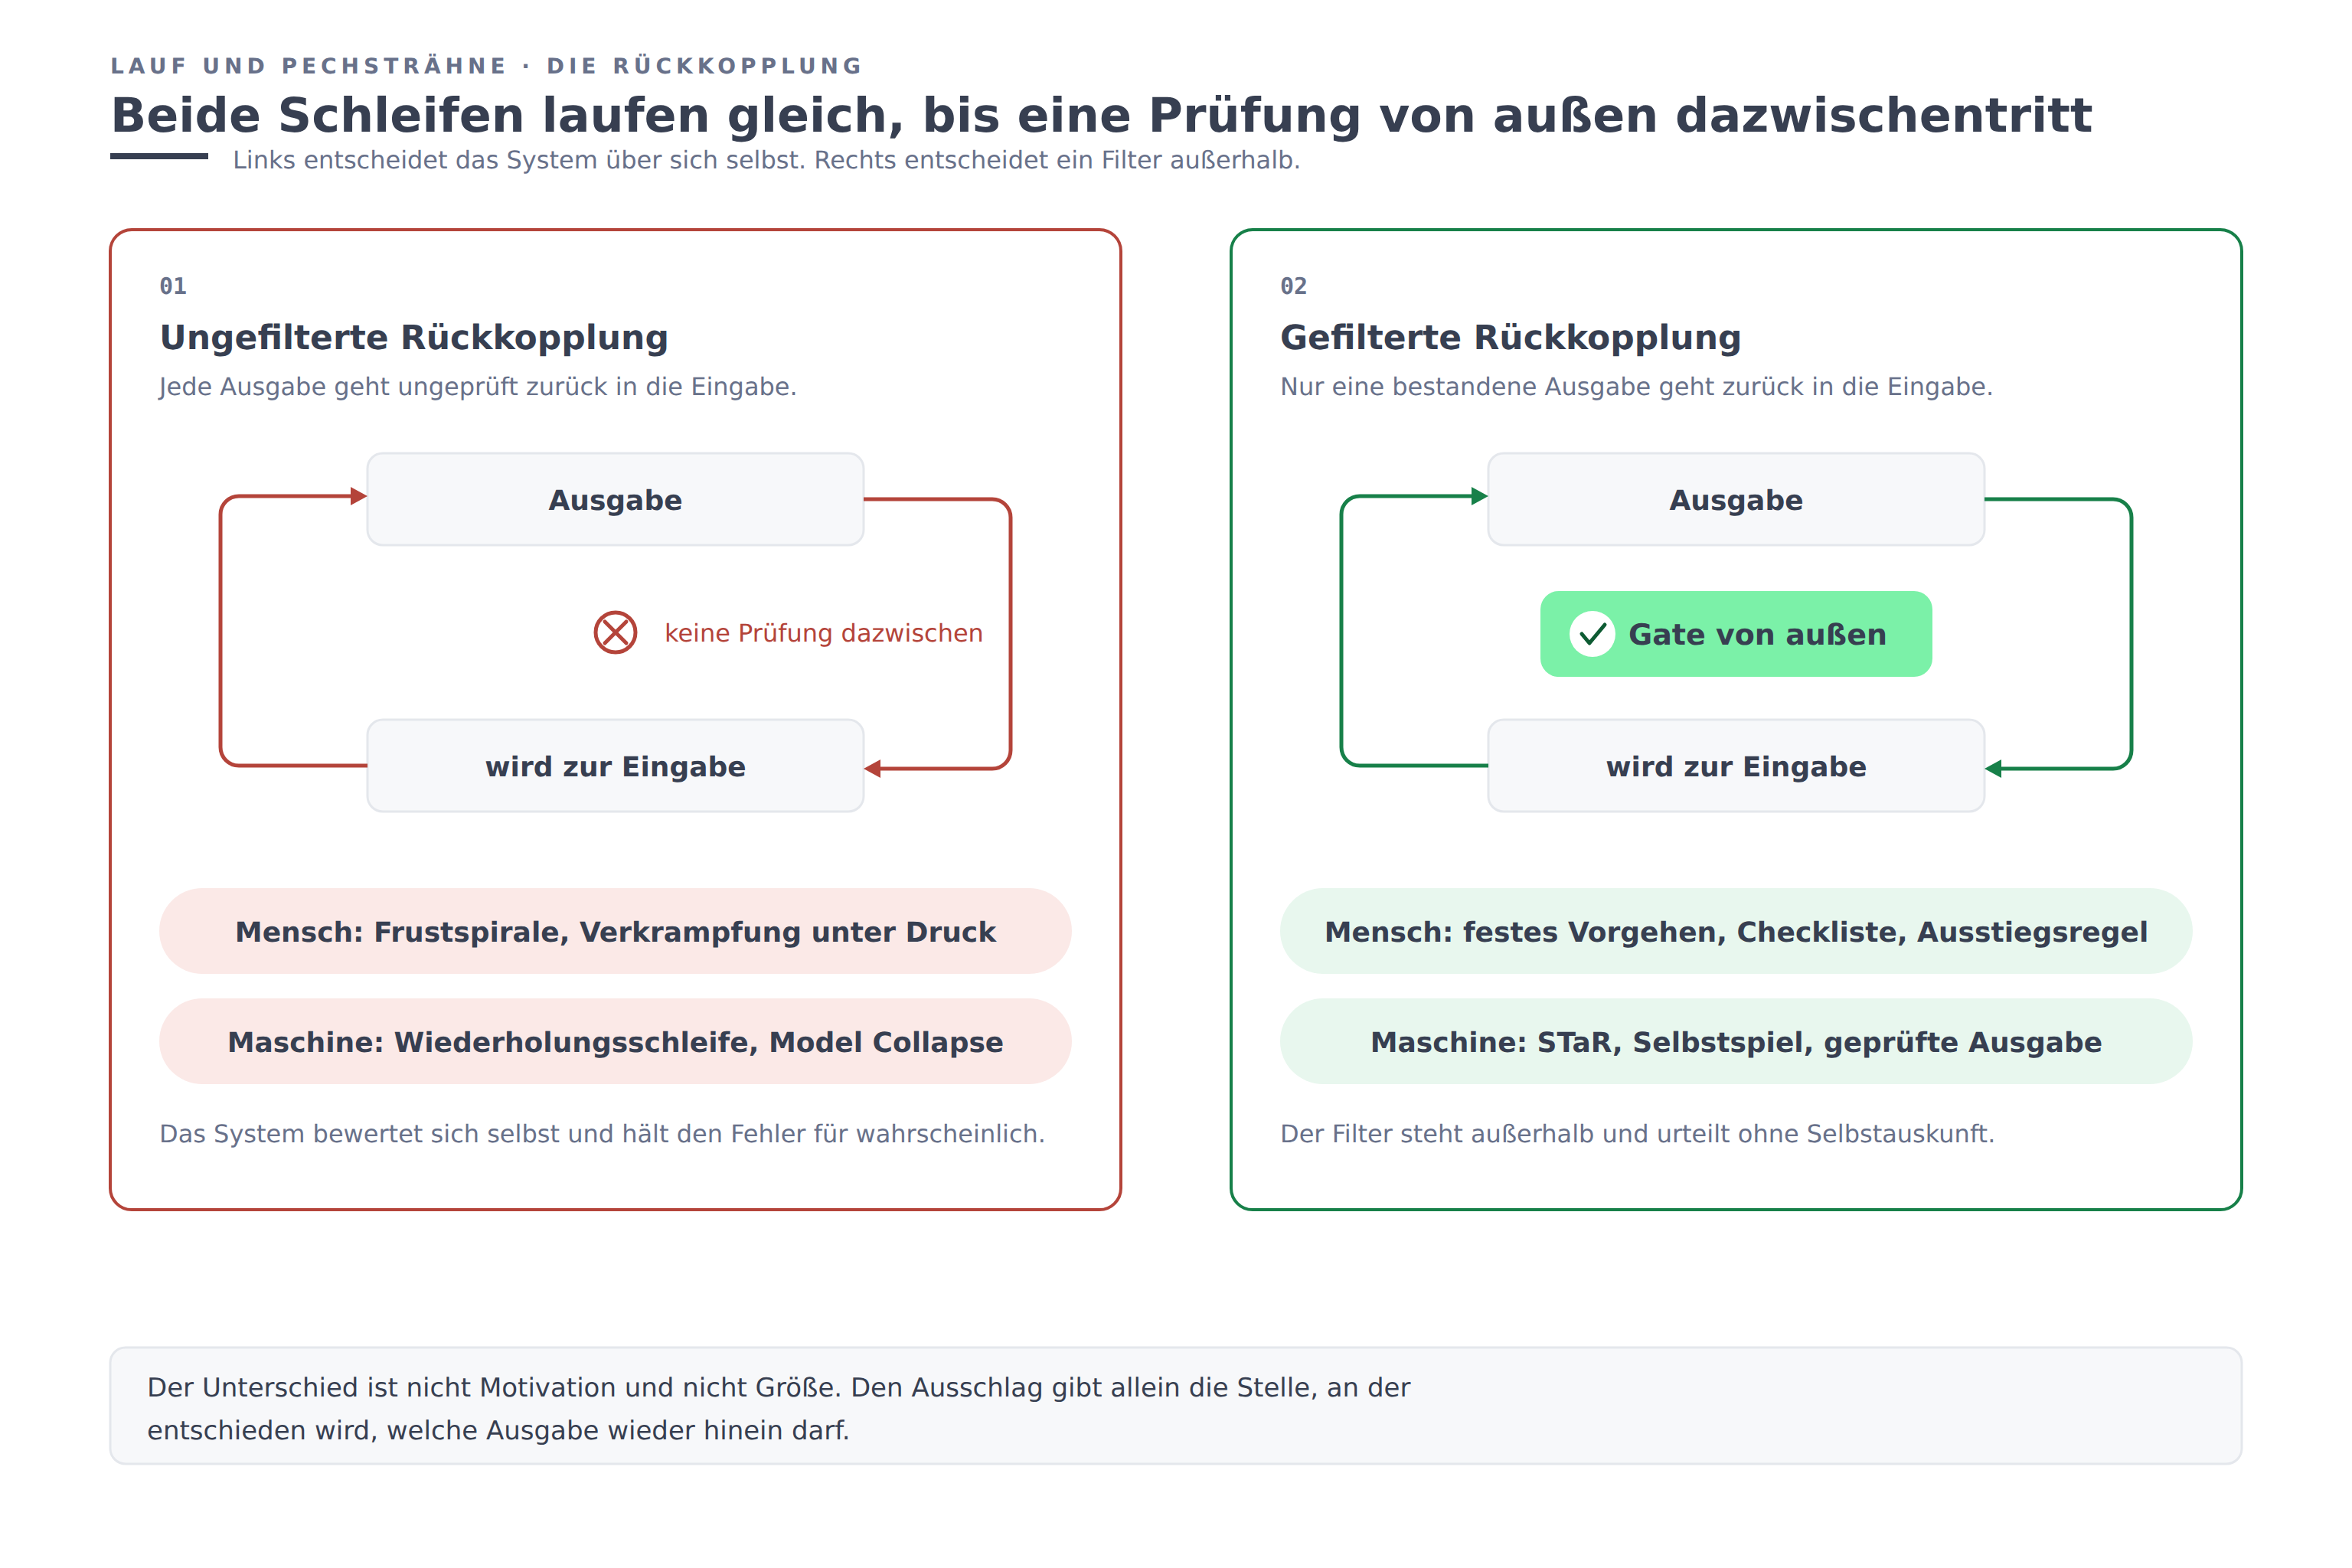
Abbildung 1: Zwei Schleifen mit gleichem Ablauf. Erst der Filter außerhalb lässt eine Ausgabe wieder hinein.
Ein Modell hat kein Dopamin und keine Muskelspannung. Seine Bauart erzeugt etwas Ähnliches. Jedes Wort im Text gehört zur Eingabe für das nächste Wort. Das ist eine Rückkopplung mit derselben Arithmetik wie beim Menschen. Abbildung 1 stellt beide Richtungen nebeneinander.
Abwärts: eine frühe falsche Annahme bleibt im Kontext stehen. Alle folgenden Schritte bauen darauf auf. Holtzman und Kollegen beschrieben den Mechanismus 2020 [5]. Eine auf höchste Wahrscheinlichkeit optimierte Dekodierung treibt den Text in Wiederholungsschleifen. Eine bereits geschriebene Wendung erhöht ihre eigene Wahrscheinlichkeit.
Aufwärts: dieselbe Schleife läuft auch in die nützliche Richtung. Schrittweises Denken verengt mit jedem richtigen Zwischenschritt den Raum für den nächsten [6]. Das Modell wird nicht klüger. Sein Kontext wird sauberer.
5. Mode Collapse ist die Trainingsfassung
Drei verschiedene Fehler tragen denselben Familiennamen. Gemeint ist jeweils ein Zusammenbruch der Antwortvielfalt (Mode Collapse), ein Rückzug auf wenige immer gleiche Muster.
Der Zusammenbruch im engen Sinn stammt aus den erzeugenden Netzen mit Gegenspieler [7]. Der Erzeuger findet eine vom Prüfer akzeptierte Ausgabe. Danach produziert er nichts anderes mehr. Die Vielfalt bricht auf wenige sichere Muster zusammen. Der Verlustwert sieht dabei weiter gut aus.
Das Training auf menschliche Rückmeldung erzeugt eine mildere Fassung. Kirk und Kollegen maßen Stufe für Stufe eine bessere Verallgemeinerung als beim rein überwachten Nachtrainieren [8]. Dasselbe Verfahren senkt die Vielfalt der Ausgaben deutlich, je Eingabe und über Eingaben hinweg. Die höfliche Standardantwort ist ein Zusammenbruch der Antwortvielfalt mit betriebswirtschaftlichem Grund.
Model Collapse ist der dritte Fall und zugleich der wörtlichste Zusammenbruch. Shumailov und Kollegen zeigten 2024 in Nature den Verlust der Verteilungsränder bei einem Modell mit Training auf eigenen Ausgaben [9]. Seltene Fakten und seltene Formulierungen verschwinden von Generation zu Generation. Am Ende entartet die Ausgabe. KI mit KI als Nahrung ist die maschinelle Form einer ungebremsten Pechsträhne.
6. Die gute Richtung gibt es auch
Ein Trainingsverfahren heißt STaR, ausgeschrieben Self-Taught Reasoner. Übersetzt ist das ein Modell als sein eigener Lehrer. Es rechnet viele Aufgaben durch. Eine Prüfung behält die Lösungswege mit nachweislich richtigem Ergebnis. Nur diese gehen in die nächste Trainingsrunde [10]. Das Brettspielprogramm AlphaGo Zero trieb dieselbe Schleife auf die Spitze: Selbstspiel gegen Kopien seiner selbst, keine menschlichen Partien, übermenschliche Spielstärke [11].
Entscheidend ist der Unterschied zwischen guter und schlechter Schleife. Motivation spielt darin keine Rolle. Größe auch nicht. Den Ausschlag gibt ein Filter außerhalb der Schleife. Er entscheidet über die Wiederaufnahme einer Ausgabe. STaR behält die Lösungen mit bestandener Probe. AlphaGo Zero behält allein die gewonnenen Partien aus dem Selbstspiel. Model Collapse entsteht bei ungefilterter Wiederaufnahme.
7. Was der Befund praktisch wert ist
Eine Rückkopplung korrigiert sich nicht von innen. Der Spieler in der Frustspirale ist der schlechteste verfügbare Richter über seinen eigenen Zustand. Das Modell in der Wiederholungsschleife hält genau diese Schleife für wahrscheinlich. In beiden Fällen kommt die Korrektur von außen. Ein festes Vorgehen. Eine Checkliste. Eine Regel für das Verlassen des Tisches. Eine Prüfung mit festem Ablauf unabhängig vom Gefühl des Spielers und unabhängig von jeder Selbstauskunft des Modells über seinen eigenen Zustand.
Das ist die ganze Begründung für Qualitäts-Gates um KI-Ausgaben. Das Modell ist dabei nicht das Problem. Kein System innerhalb einer Rückkopplung ist ein verlässlicher Richter über sich selbst. Ein außerhalb des Modells sieht die Dinge ohne Selbstauskunft des Modells.
Eine ehrliche Grenze bleibt. Die Parallele zwischen Mensch und Maschine ist strukturell und bleibt ohne biologische Entsprechung. Cortisol und Aufmerksamkeit sind keine Wahrscheinlichkeitsverteilungen. Nichts hier behauptet ein Empfinden des Modells. Gemeinsam ist die Arithmetik der Rückkopplung. Sie allein sagt beide Fehlerbilder des Laufs zuverlässig voraus.
8. Der Mensch als zweite Schleife
Die Rückkopplung endet nicht im Modell. Sie läuft über den Menschen davor weiter. Laban und Kollegen stellten neun Modellen nach der ersten Antwort eine einzige Rückfrage: sind Sie sicher [12]. Die Modelle wechselten ihre Antwort in 46 % der Fälle. Die Genauigkeit fiel dabei im Mittel um 17 Prozentpunkte. Nachhaken unter Druck verschlechtert das Ergebnis also messbar.
Der Grund liegt im Training. Sharma und Kollegen zeigten für Modelle aus menschlicher Rückmeldung eine gelernte Neigung zur Meinung des Nutzers [13]. Zustimmung ist einer der stärksten Vorhersagewerte für eine gut bewertete Antwort. Ein gereizter Nutzer bekommt deshalb die passende Antwort statt der richtigen.
Der Ton wirkt genauso. Yin und Kollegen prüften Höflichkeitsstufen in Englisch, Chinesisch und Japanisch [14]. Unhöfliche Aufforderungen senkten die Leistung. Übertriebene Höflichkeit hob sie nicht. Die Größe des Effekts hängt von Sprache und Modell ab. Die Richtung bleibt gleich: die Stimmung des Menschen wandert in das Ergebnis.
9. Sieben Regeln für den nächsten Lauf
Der Befund lässt sich in sieben Regeln fassen. Sie gelten am Kartentisch, im Sport und vor dem Bildschirm. Abbildung 2 stellt sie auf eine Tafel.
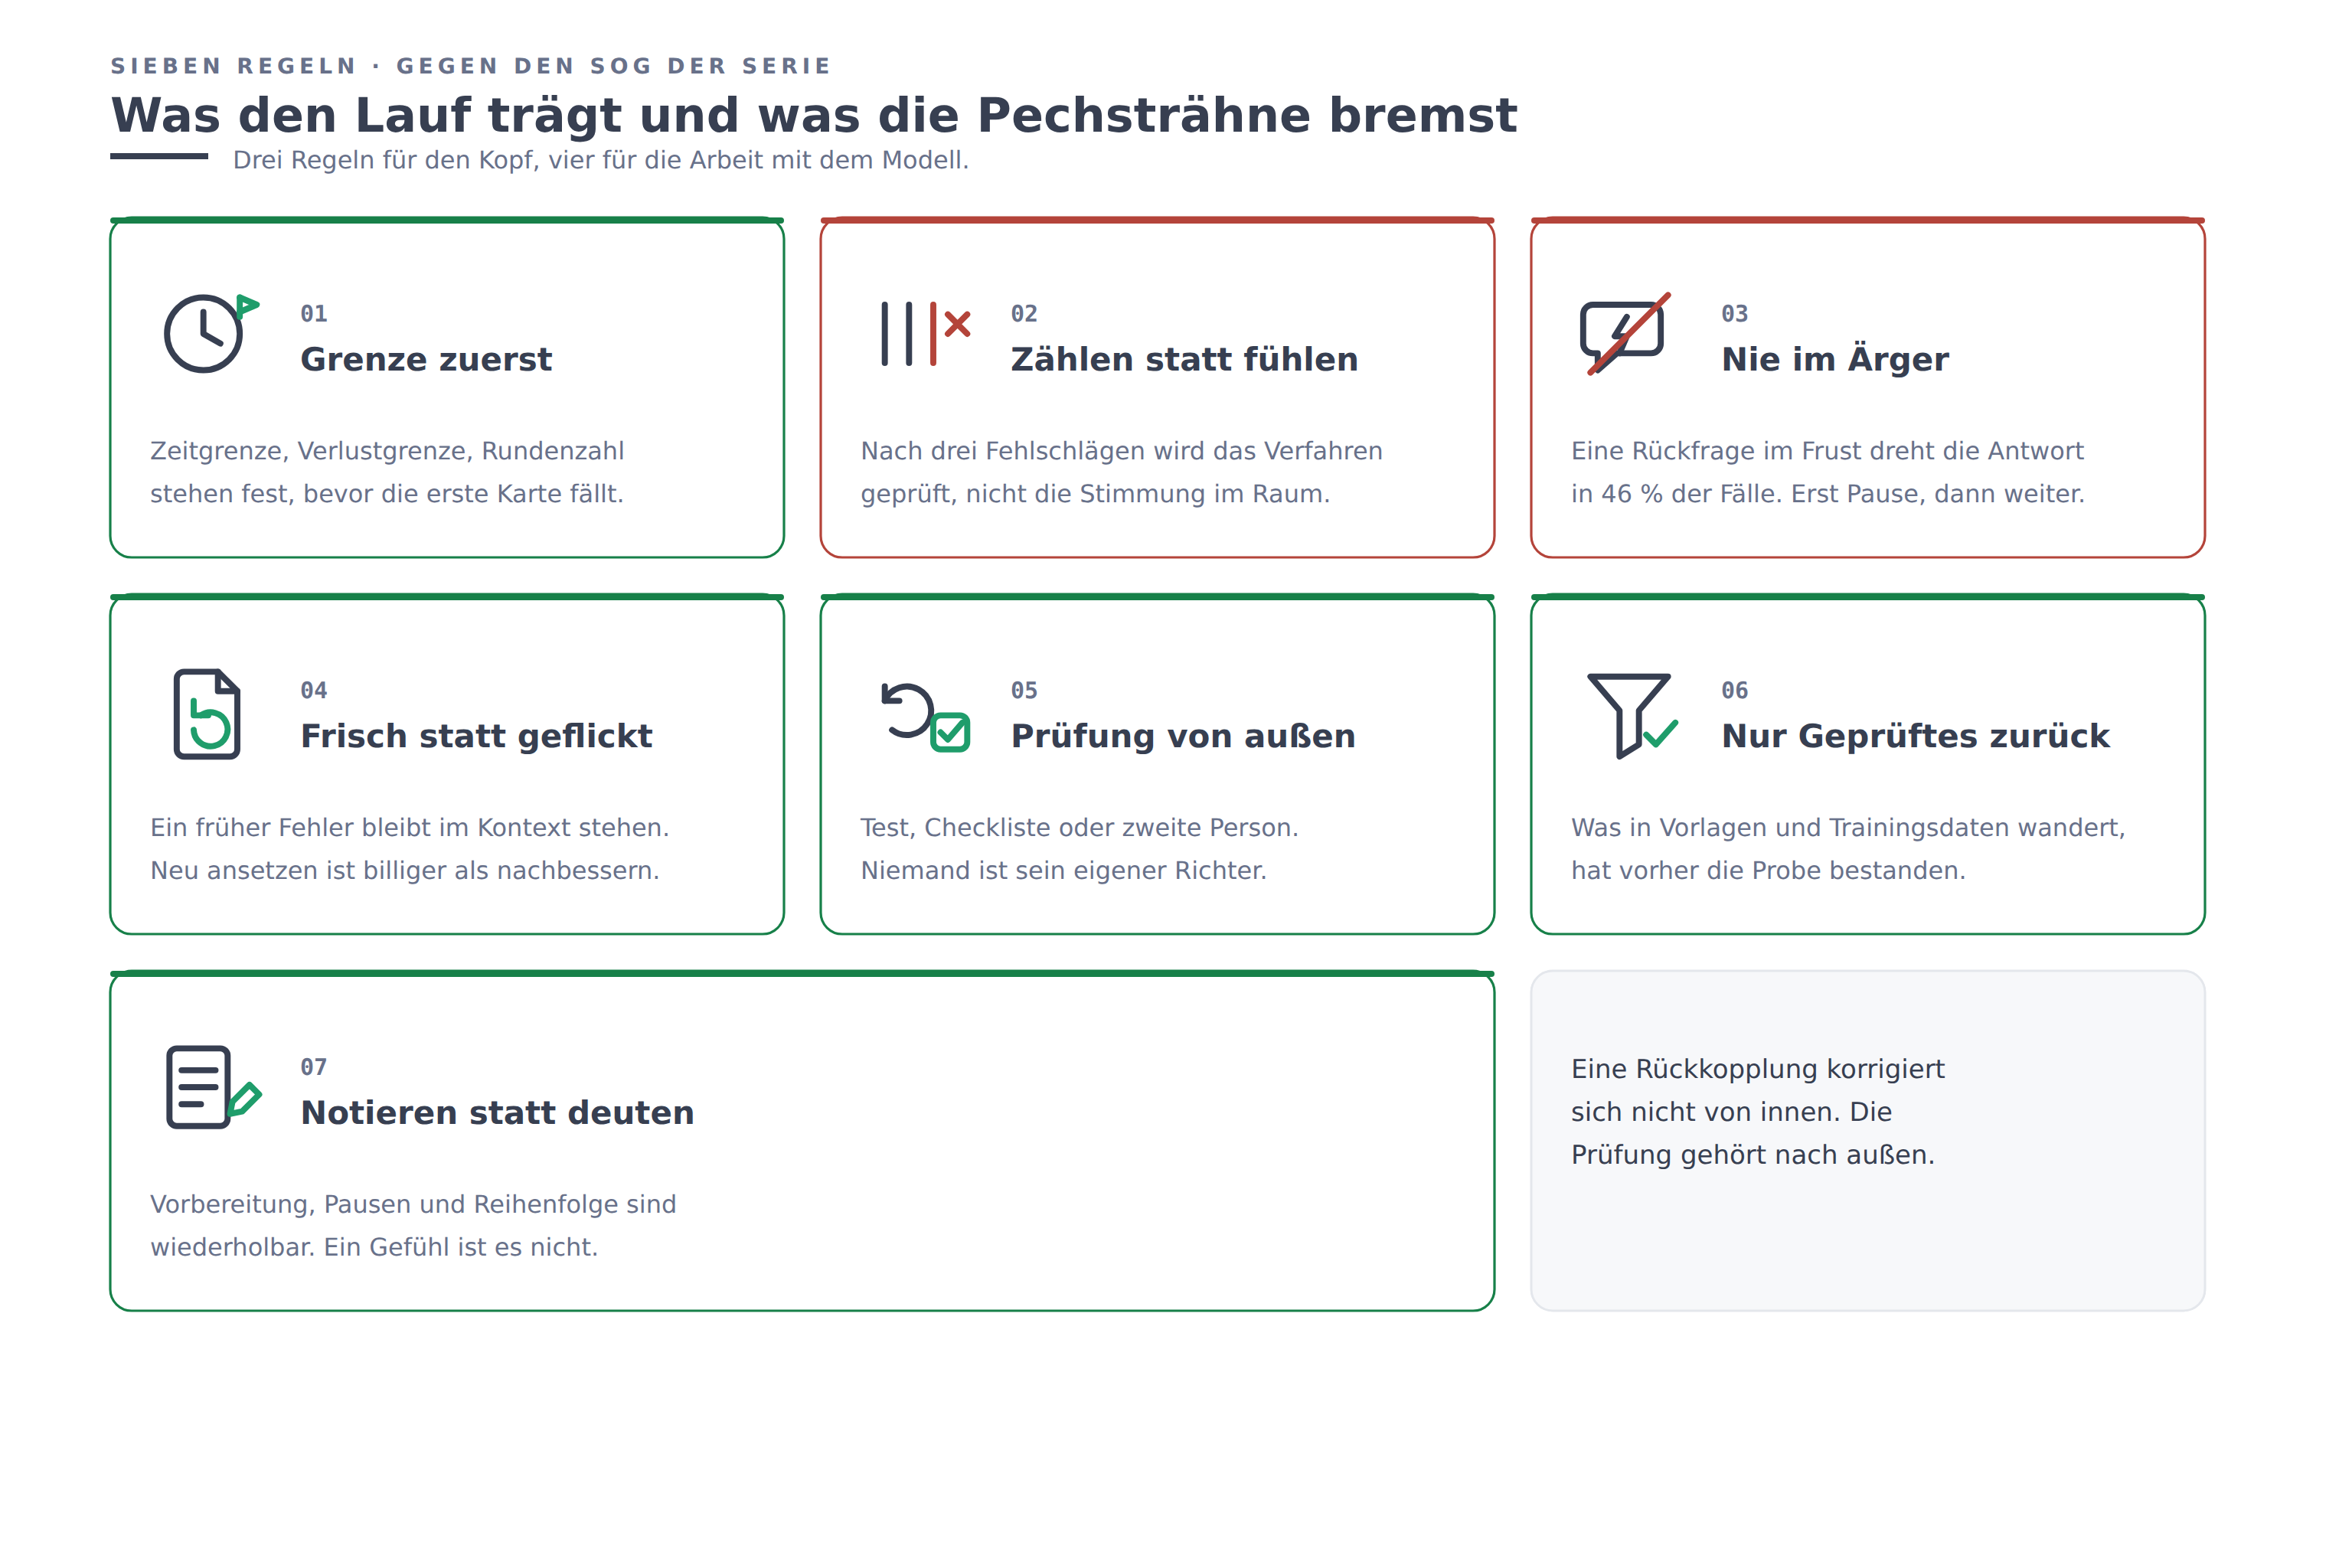
Abbildung 2: Die sieben Regeln auf einen Blick. sind die zwei Regeln gegen die Pechsträhne.
10. Download: der Spickzettel
Die sieben Regeln auf einem Blatt. Sein Platz ist neben dem Tisch oder dem Bildschirm.
Spickzettel als PDF herunterladen
Herunterladen1. Zuerst die Ausstiegsregel festlegen. Zeitgrenze, Verlustgrenze, Rundenzahl, notiert vor dem ersten Blatt.
2. Nach drei Fehlschlägen das Verfahren prüfen. Drei ist eine Zahl und eine Stimmung ist keine. Über den Abbruch entscheidet die Zählung.
3. Nie im Ärger mit einem Modell arbeiten. Eine einzige Rückfrage dreht die Antwort in 46 % der Fälle und kostet 17 Prozentpunkte Genauigkeit.
4. Den frühen Fehler nicht nachbessern. Ein frischer Kontext ist billiger als die Reparatur auf einer falschen Annahme.
5. Die Prüfung außerhalb der Schleife halten. Kein System innerhalb einer Rückkopplung ist ein verlässlicher Richter über sich selbst.
6. Nur Geprüftes zurückspeisen. Vorlagen, Textbausteine und Trainingsdaten wachsen sonst aus den eigenen Fehlern.
7. Den guten Lauf protokollieren statt deuten. Vorbereitung, Pausen und Reihenfolge sind wiederholbar. Ein Gefühl ist es nicht.
11. Quellen
[1] T. Gilovich, R. Vallone und A. Tversky, „The Hot Hand in Basketball: On the Misperception of Random Sequences", Cognitive Psychology, Bd. 17, Nr. 3, S. 295 bis 314, 1985
[2] J. B. Miller und A. Sanjurjo, „Surprised by the Hot Hand Fallacy? A Truth in the Law of Small Numbers", Econometrica, Bd. 86, Nr. 6, S. 2019 bis 2047, 2018, doi:10.3982/ECTA14943
[3] S. L. Beilock und T. H. Carr, „On the Fragility of Skilled Performance: What Governs Choking Under Pressure?", Journal of Experimental Psychology: General, Bd. 130, Nr. 4, S. 701 bis 725, 2001
[4] J. Palomäki, M. Laakasuo und M. Salmela, „Losing More by Losing It: Poker Experience, Sensitivity to Losses and Tilting Severity", Journal of Gambling Studies, Bd. 29, Nr. 2, S. 187 bis 200, 2013
[5] A. Holtzman, J. Buys, L. Du, M. Forbes und Y. Choi, „The Curious Case of Neural Text Degeneration", ICLR, 2020
[6] J. Wei, X. Wang, D. Schuurmans, M. Bosma, E. Chi, Q. Le und D. Zhou, „Chain-of-Thought Elicits Reasoning in Large Language Models", NeurIPS, 2022
[7] I. Goodfellow, J. Pouget-Abadie, M. Mirza, B. Xu, D. Warde-Farley, S. Ozair, A. Courville und Y. Bengio, „Generative Adversarial Nets", NeurIPS, 2014
[8] R. Kirk, I. Mediratta, C. Nalmpantis, J. Luketina, E. Hambro, E. Grefenstette und R. Raileanu, „Understanding the Effects of RLHF on Generalisation and Diversity", ICLR, 2024, arXiv:2310.06452
[9] I. Shumailov, Z. Shumaylov, Y. Zhao, N. Papernot, R. Anderson und Y. Gal, „AI models collapse when trained on recursively generated data", Nature, Bd. 631, S. 755 bis 759, 2024, doi:10.1038/s41586-024-07566-y
[10] E. Zelikman, Y. Wu, J. Mu und N. D. Goodman, „STaR: Bootstrapping Reasoning With Reasoning", NeurIPS, 2022
[11] D. Silver, J. Schrittwieser, K. Simonyan, I. Antonoglou, A. Huang, A. Guez, T. Hubert, L. Baker, M. Lai, A. Bolton, Y. Chen, T. Lillicrap, F. Hui, L. Sifre, G. van den Driessche, T. Graepel und D. Hassabis, „Mastering the game of Go without human knowledge", Nature, Bd. 550, S. 354 bis 359, 2017
[12] P. Laban, L. Murakhovs'ka, C. Xiong und C.-S. Wu, „Are You Sure? Challenging LLMs Leads to Performance Drops in The FlipFlop Experiment", 2023, arXiv:2311.08596
[13] M. Sharma, M. Tong, T. Korbak, D. Duvenaud, A. Askell, S. R. Bowman und Kollegen, „Towards Understanding in Language Models", ICLR, 2024, arXiv:2310.13548
[14] Z. Yin, H. Wang, K. Horio, D. Kawahara und S. Sekine, „Should We Respect LLMs? A Cross-Lingual Study on the Influence of Prompt Politeness on LLM Performance", SICon at ACL, 2024, arXiv:2402.14531